

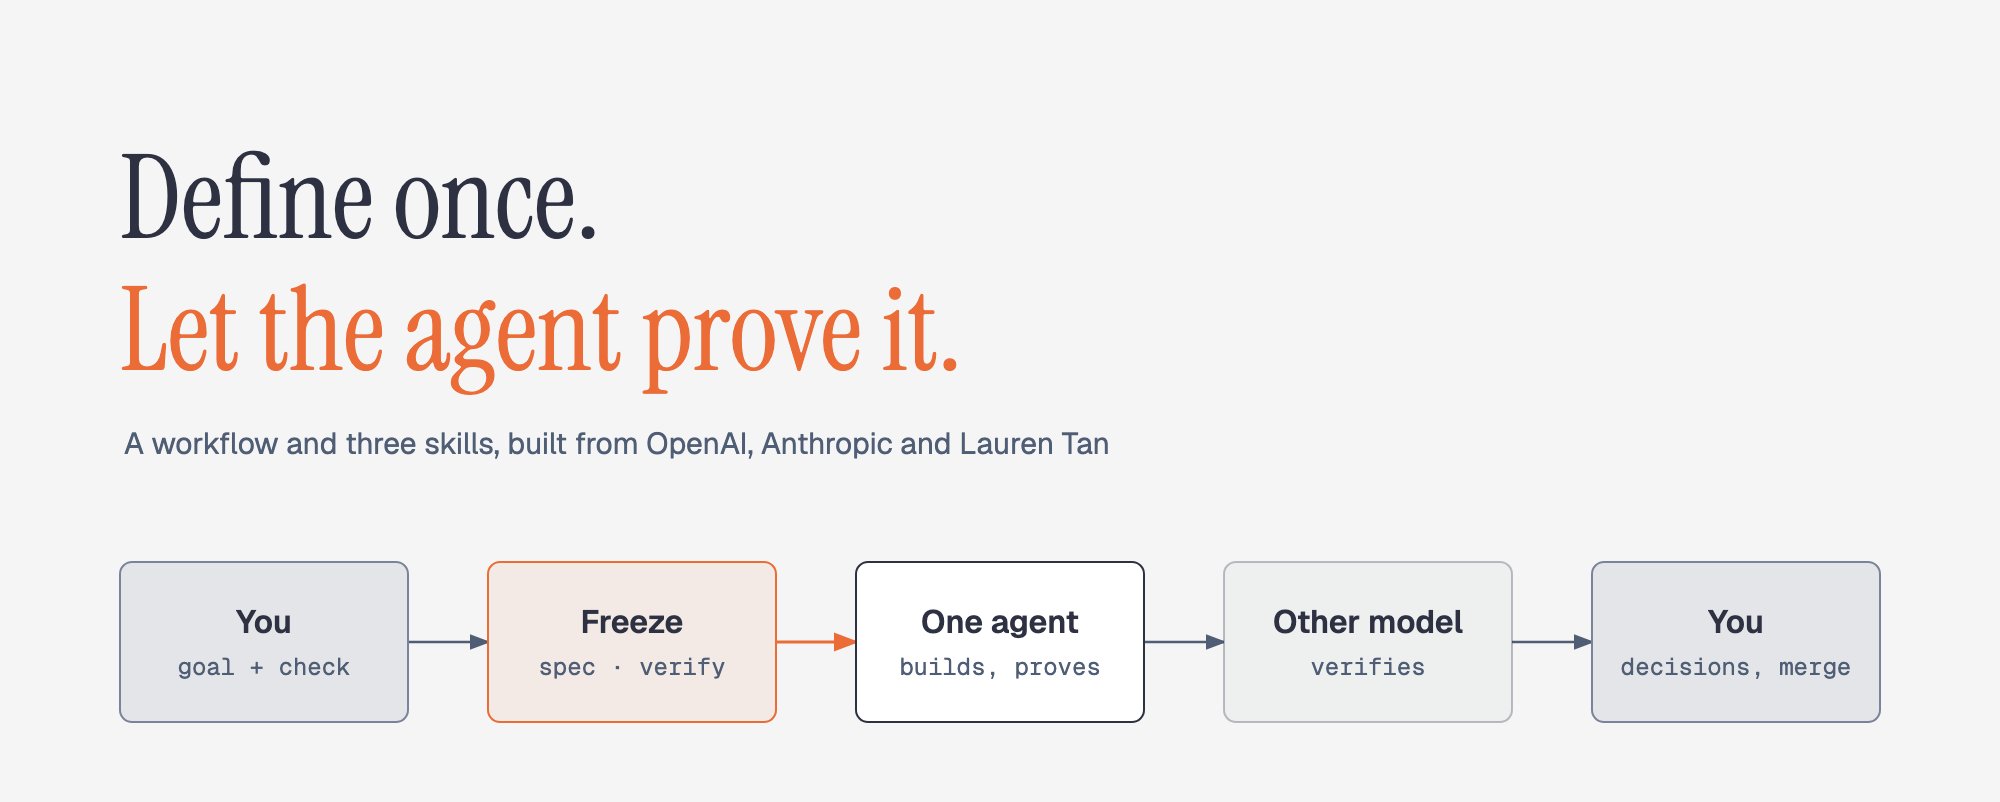
我从哪里开始
我是 MCode 的后端工程师。MCode 是 MiniMax 的编程 Agent,有桌面应用和终端界面。我写代码几乎全靠 Agent,第一优先用 MCode:我自己在做它,日常开发就先用它。同时也用 Codex 和 Claude Code 做交叉检查,看看它们会怎么处理同一件事。 为了做得更多,我写了 Agent Lord,让一个 Agent 会话把工作分给其他会话。从一个 Codex 会话出发,把功能拆成模块,每个模块交给一个独立的 CLI,通常是 MCode,在各自的 git worktree 里开发。互不依赖的模块并行做,评审时让两个模型家族互相检查,最后由一个整合者合并。在后来统计的那个月里,它派发了 490 次操作,涉及 214 个任务。 当时的想法很简单:同时干活的 Agent 越多,做完的事情就越多。 到了 9 月中旬,实际感受却不是这样。下面是我在同一天发给 Agent 的话:我现在觉得特别繁琐,实现起来特别慢。
tickets 需要这么多吗?不能合并?
这都读一小时了。
为什么不能多派点,只要不依赖,不能都派出去吗?
多加几个 Agent,解决不了这次的问题
最后那句话就是我当时的判断:并行度不够。Agent Lord 花了一晚上,分 8 个模块做 MCode Goal 功能的新版本。跑完以后,我让 Agent 审计这次执行,看看为什么真正并行的时间这么少。- 最多只有 4 个 CLI 同时运行,平均 1.27 个。
- 限制并行度的不是 Agent Lord,而是计划:模块排成了一条依赖链,后一个要等前一个交付。
- 等待也没解决问题。下游模块仍然从原始代码开工,看不到上游刚写的代码,只能对着桩实现。真正的代码直到最后合并时才第一次碰到一起。
- 每个 CLI 内部,大部分时间在等模型,每轮通常只调用一个工具。有个模块来回了 91 轮,约 56 分钟,才写下第一个文件。
真正的问题是什么
第二天,我让 Agent 扫了此前 30 天的全部会话,MCode、Codex 和 Claude Code 加起来约 1,700 个,想看看那次是不是个例。它们细读了 40 条任务链,并把引文和原始日志逐一核对。结果不是个例,有两个问题贯穿了整个月。 Bug 发现得晚,而且是我发现的。 Agent 说做完了,测试也过了。等我自己用,或者把各部分接起来,问题才出现。- Goal 功能的两个 PR 都被标记为完成,测试全绿。我跑开发版时发现,如果在 Agent 等待后台工作时更新目标,它就不再接着干了。
- 状态栏显示推理强度是
xhigh,会话实际按medium运行,因为新会话没把设置传下去。 - Goal 重做的各个模块都交付了,默认生产配置里却没打开这个功能。
- 8 月就定好了 MCode 的四档沙箱权限,到了 9 月,我还在跟 Agent 强调:四档,不要再加额外保护。
- 主会话把计划交给另一个 CLI 做交叉评审,擅自加了一句“保持精炼”。原本 875 行的计划被 279 行替换,逐文件迁移表、接口、连接步骤和验收检查都丢了。
- 我要求基于最新集成分支开 PR,结果开到了功能分支上。修正它,做了一次 rebase,还处理了三处合并冲突。
我是怎么选中这三家的
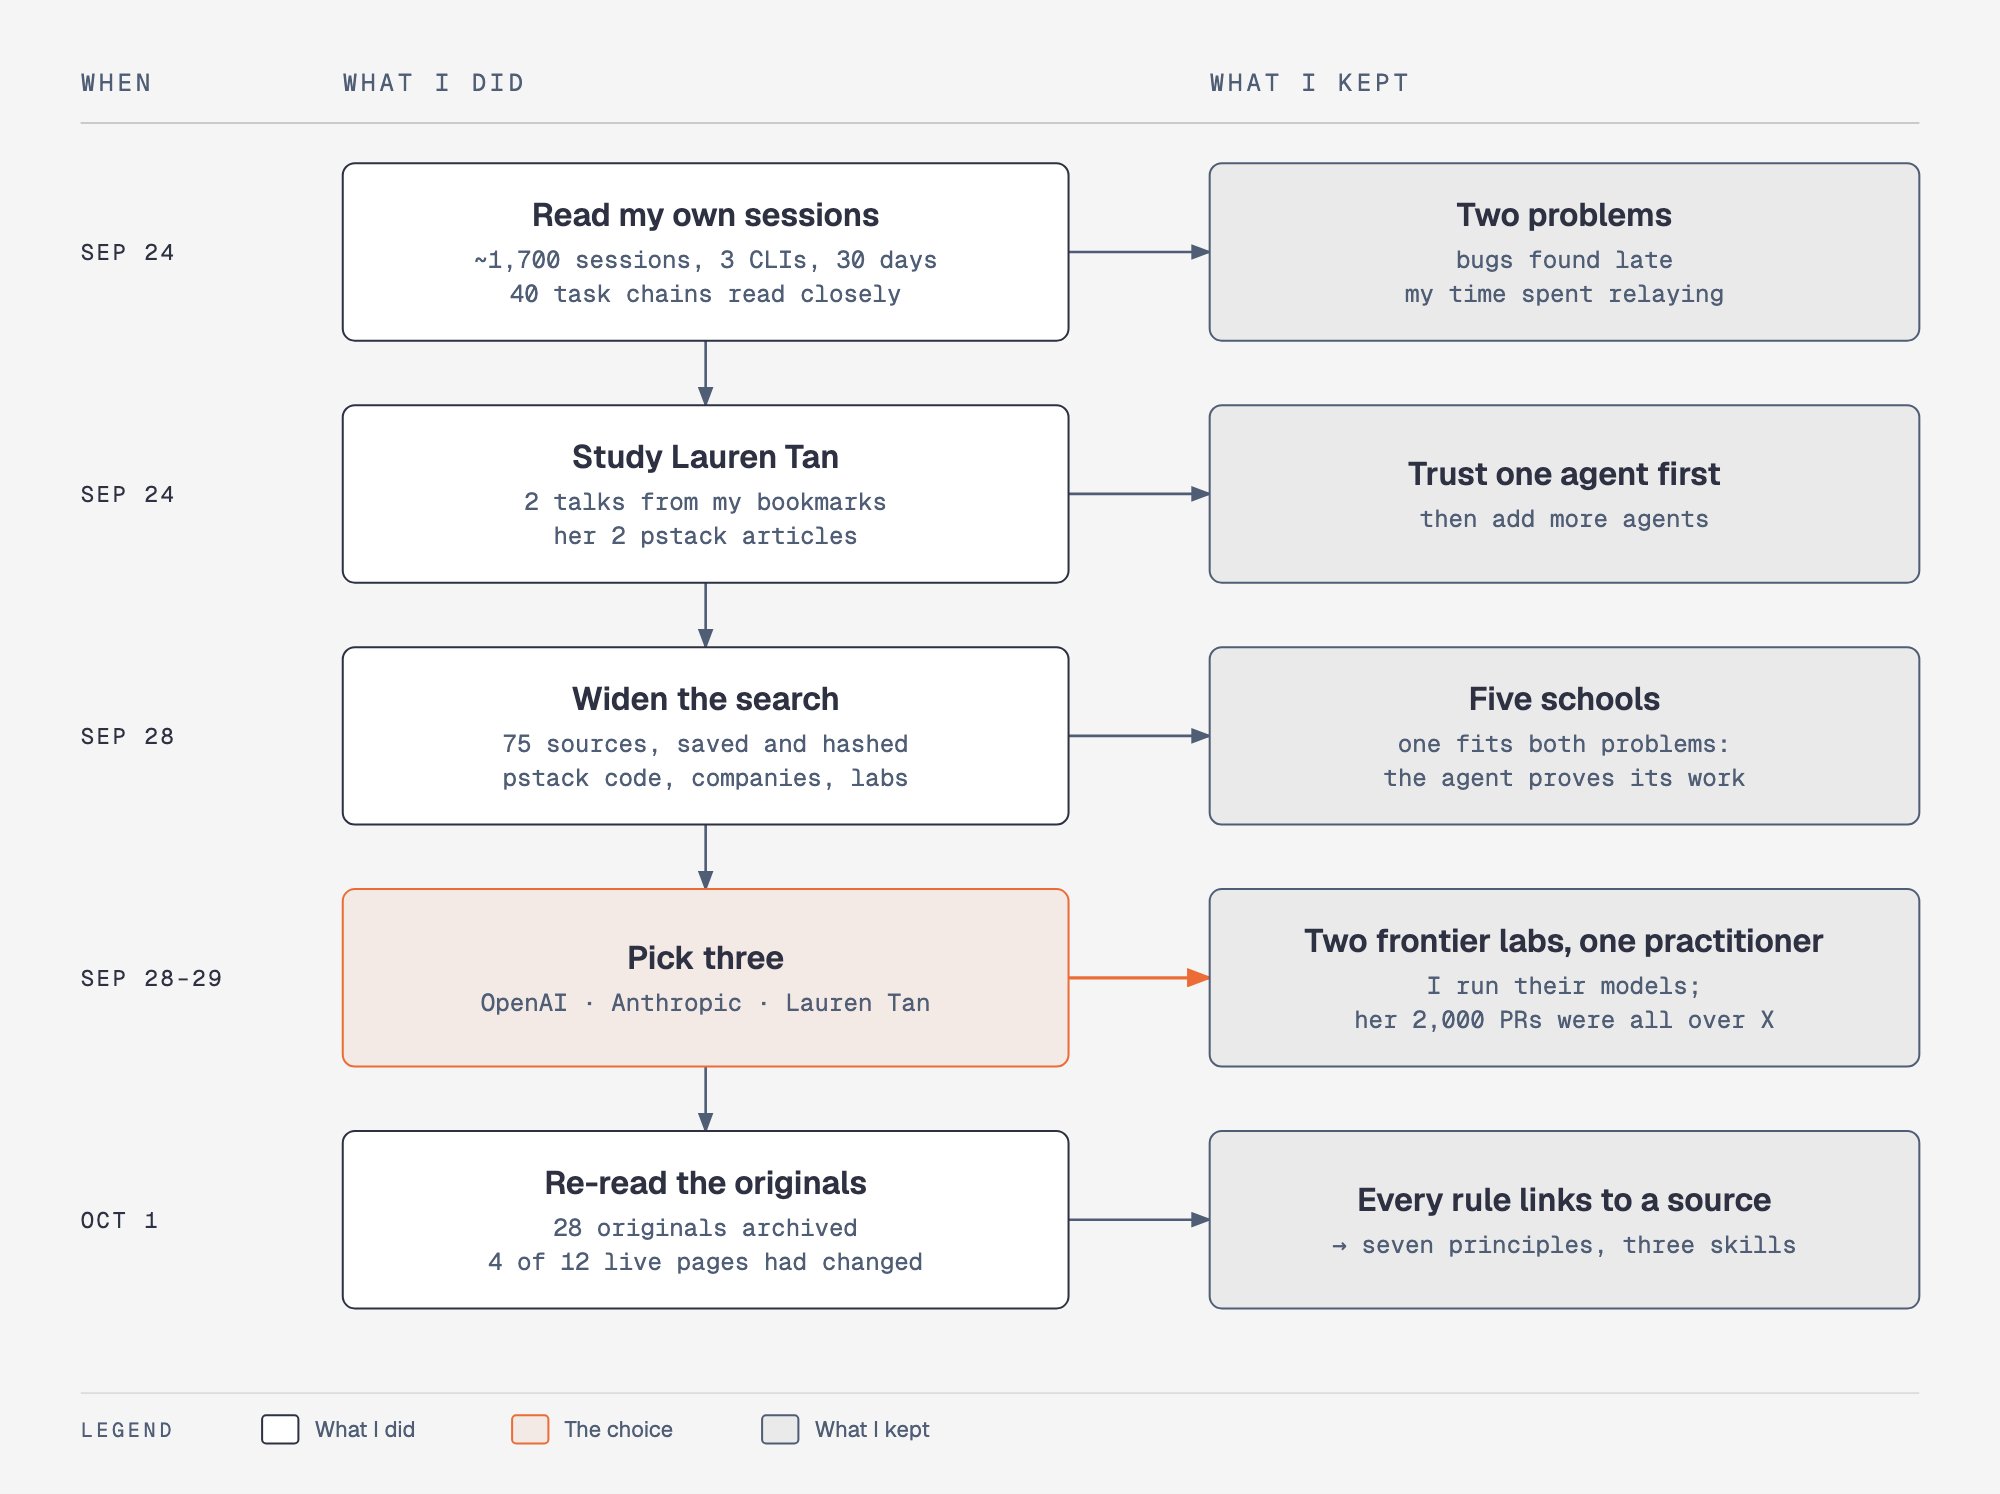
工作流一览
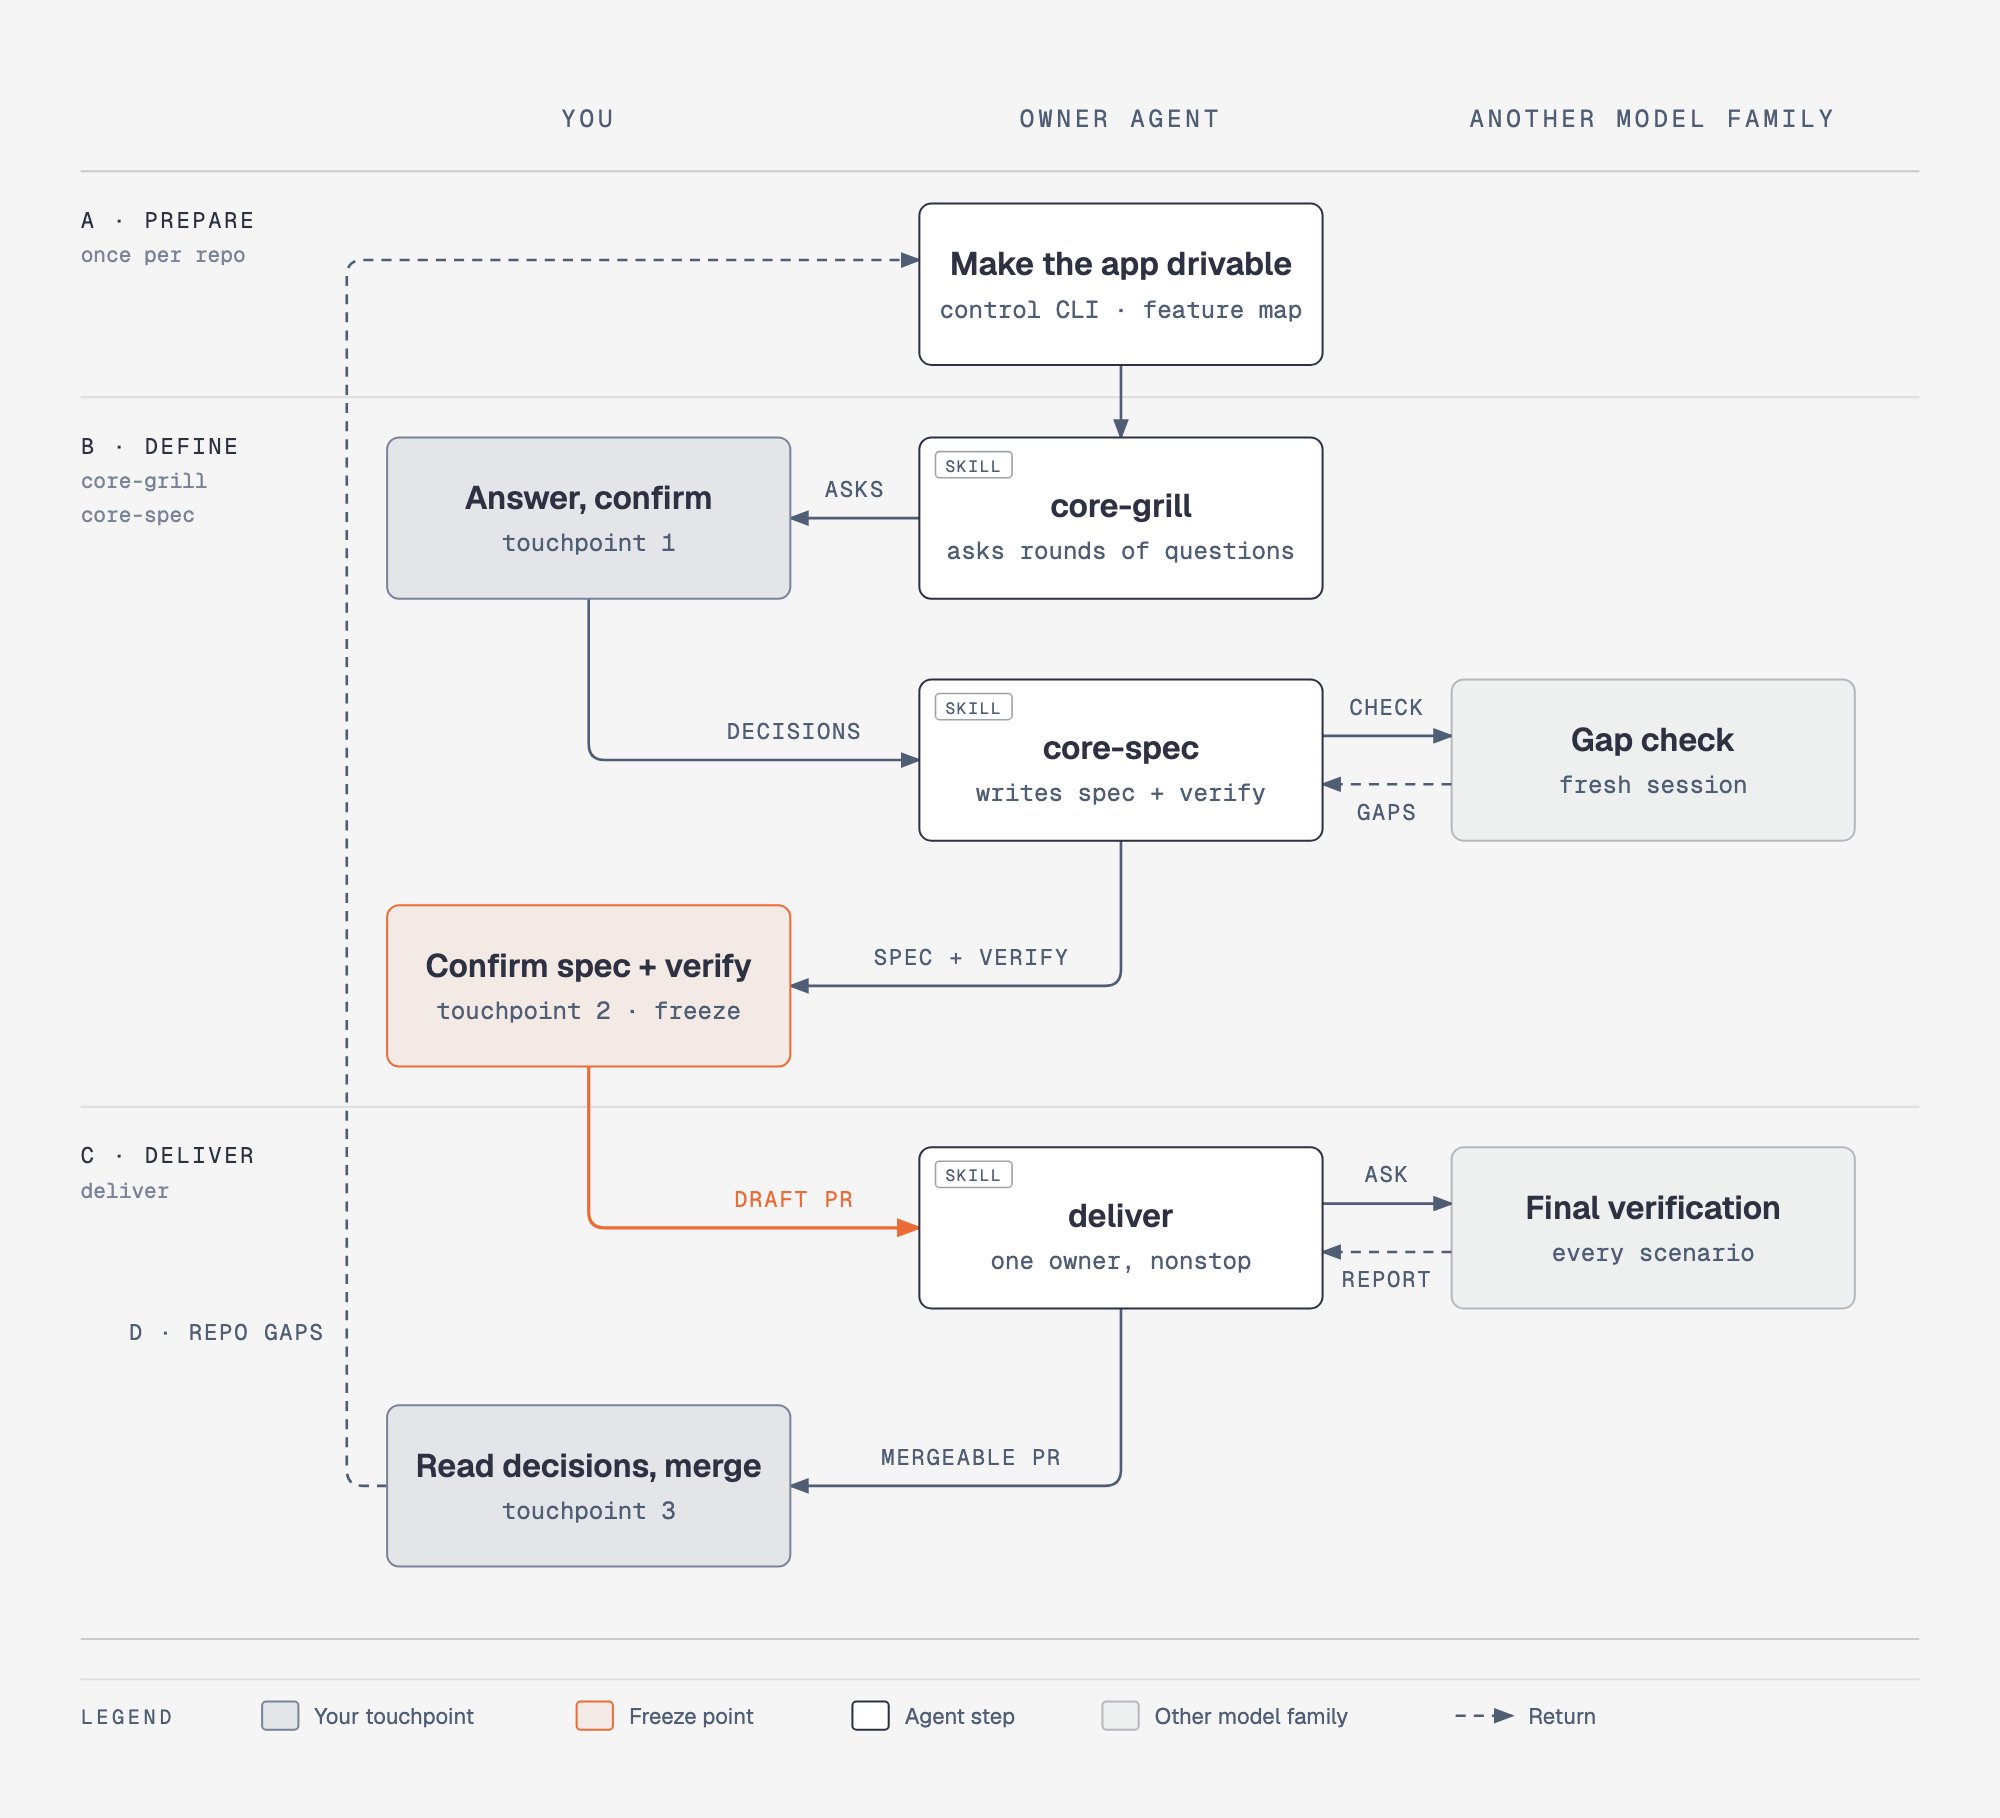
core-grill 澄清需求,core-spec 记录决定和验证方式,再由另一个模型家族查漏。我确认后,将文件冻结在功能分支上,开一个草稿 PR。
C. 交付,由 Agent 推进。 我在新会话里运行 /deliver <草稿 PR 链接>。一个主 Agent 负责实现、测试、协调独立检查,处理 CI 和评审,直到 PR 可以合入。它在不可逆操作前暂停,并把过程中做过的决定记录下来,供我审阅。
D. 回流。 PR 列出这次执行暴露的仓库缺口。我来判断,哪些要补进仓库工具,哪些要改进 Skill。
我只需要参与三个位置:回答问题,确认 spec.md 和 verify.md,最后看决定清单并合入。
三个 Skill 分别做什么
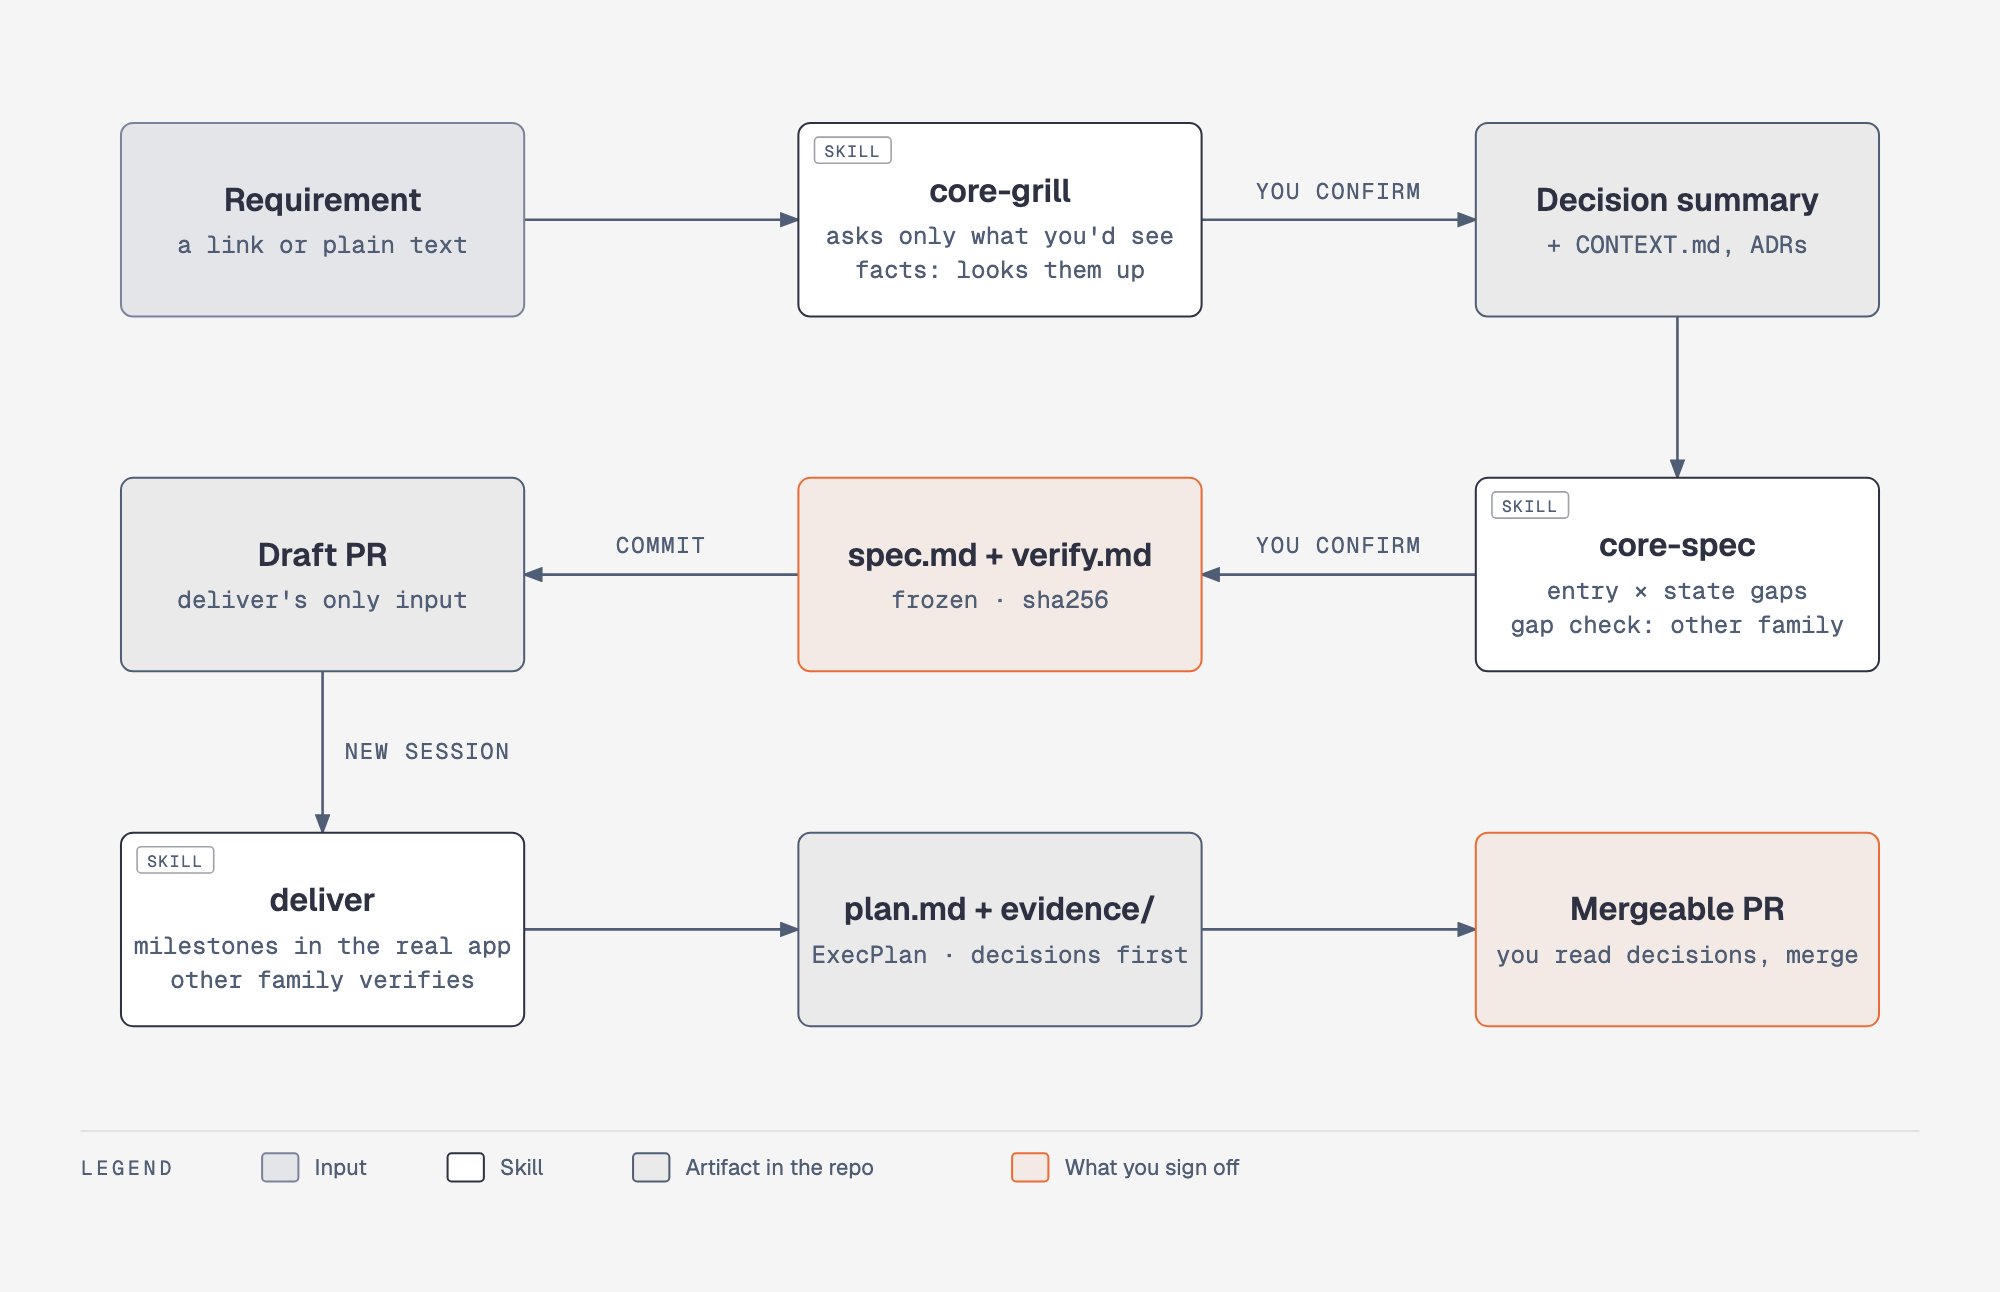
core-grill:只问会影响用户的决定
它先弄清楚需求、目标、怎样算完成,以及允许它做什么。仓库里能查到答案的问题,先自己查。 它问我的,是会改变用户体验的选择:行为、文案、默认值、入口,以及是否可能丢失数据。每个问题都带选项、后果和推荐。实现上的选择由它自己处理,采用的默认方案也记下来。最后,我确认它整理出的决定汇总。core-spec:写两份文件,由另一家模型检查,再冻结
它把决定汇总写成spec.md 和 verify.md:前者记录定了什么,后者说明怎么证明做到了。
有用的地方是,先写检查,再写代码。每个场景都从真实入口出发,走完一次完整的用户操作,并写清楚旧代码应该表现成什么样。如果旧代码的表现不足以暴露风险,还要写出一种检查必须拒绝的错误实现。这样,需求里的缺口就得提前暴露出来。
另一个模型家族在全新的只读会话里检查两份文件,不带上作者的推理过程。找不到这个审阅者,就不冻结。查漏结束、我确认之后,两份文件冻结并提交,再开草稿 PR。deliver 只需要拿到这个链接,就能接着做。
deliver:一个主 Agent 负责到底,直到 PR 可以合入
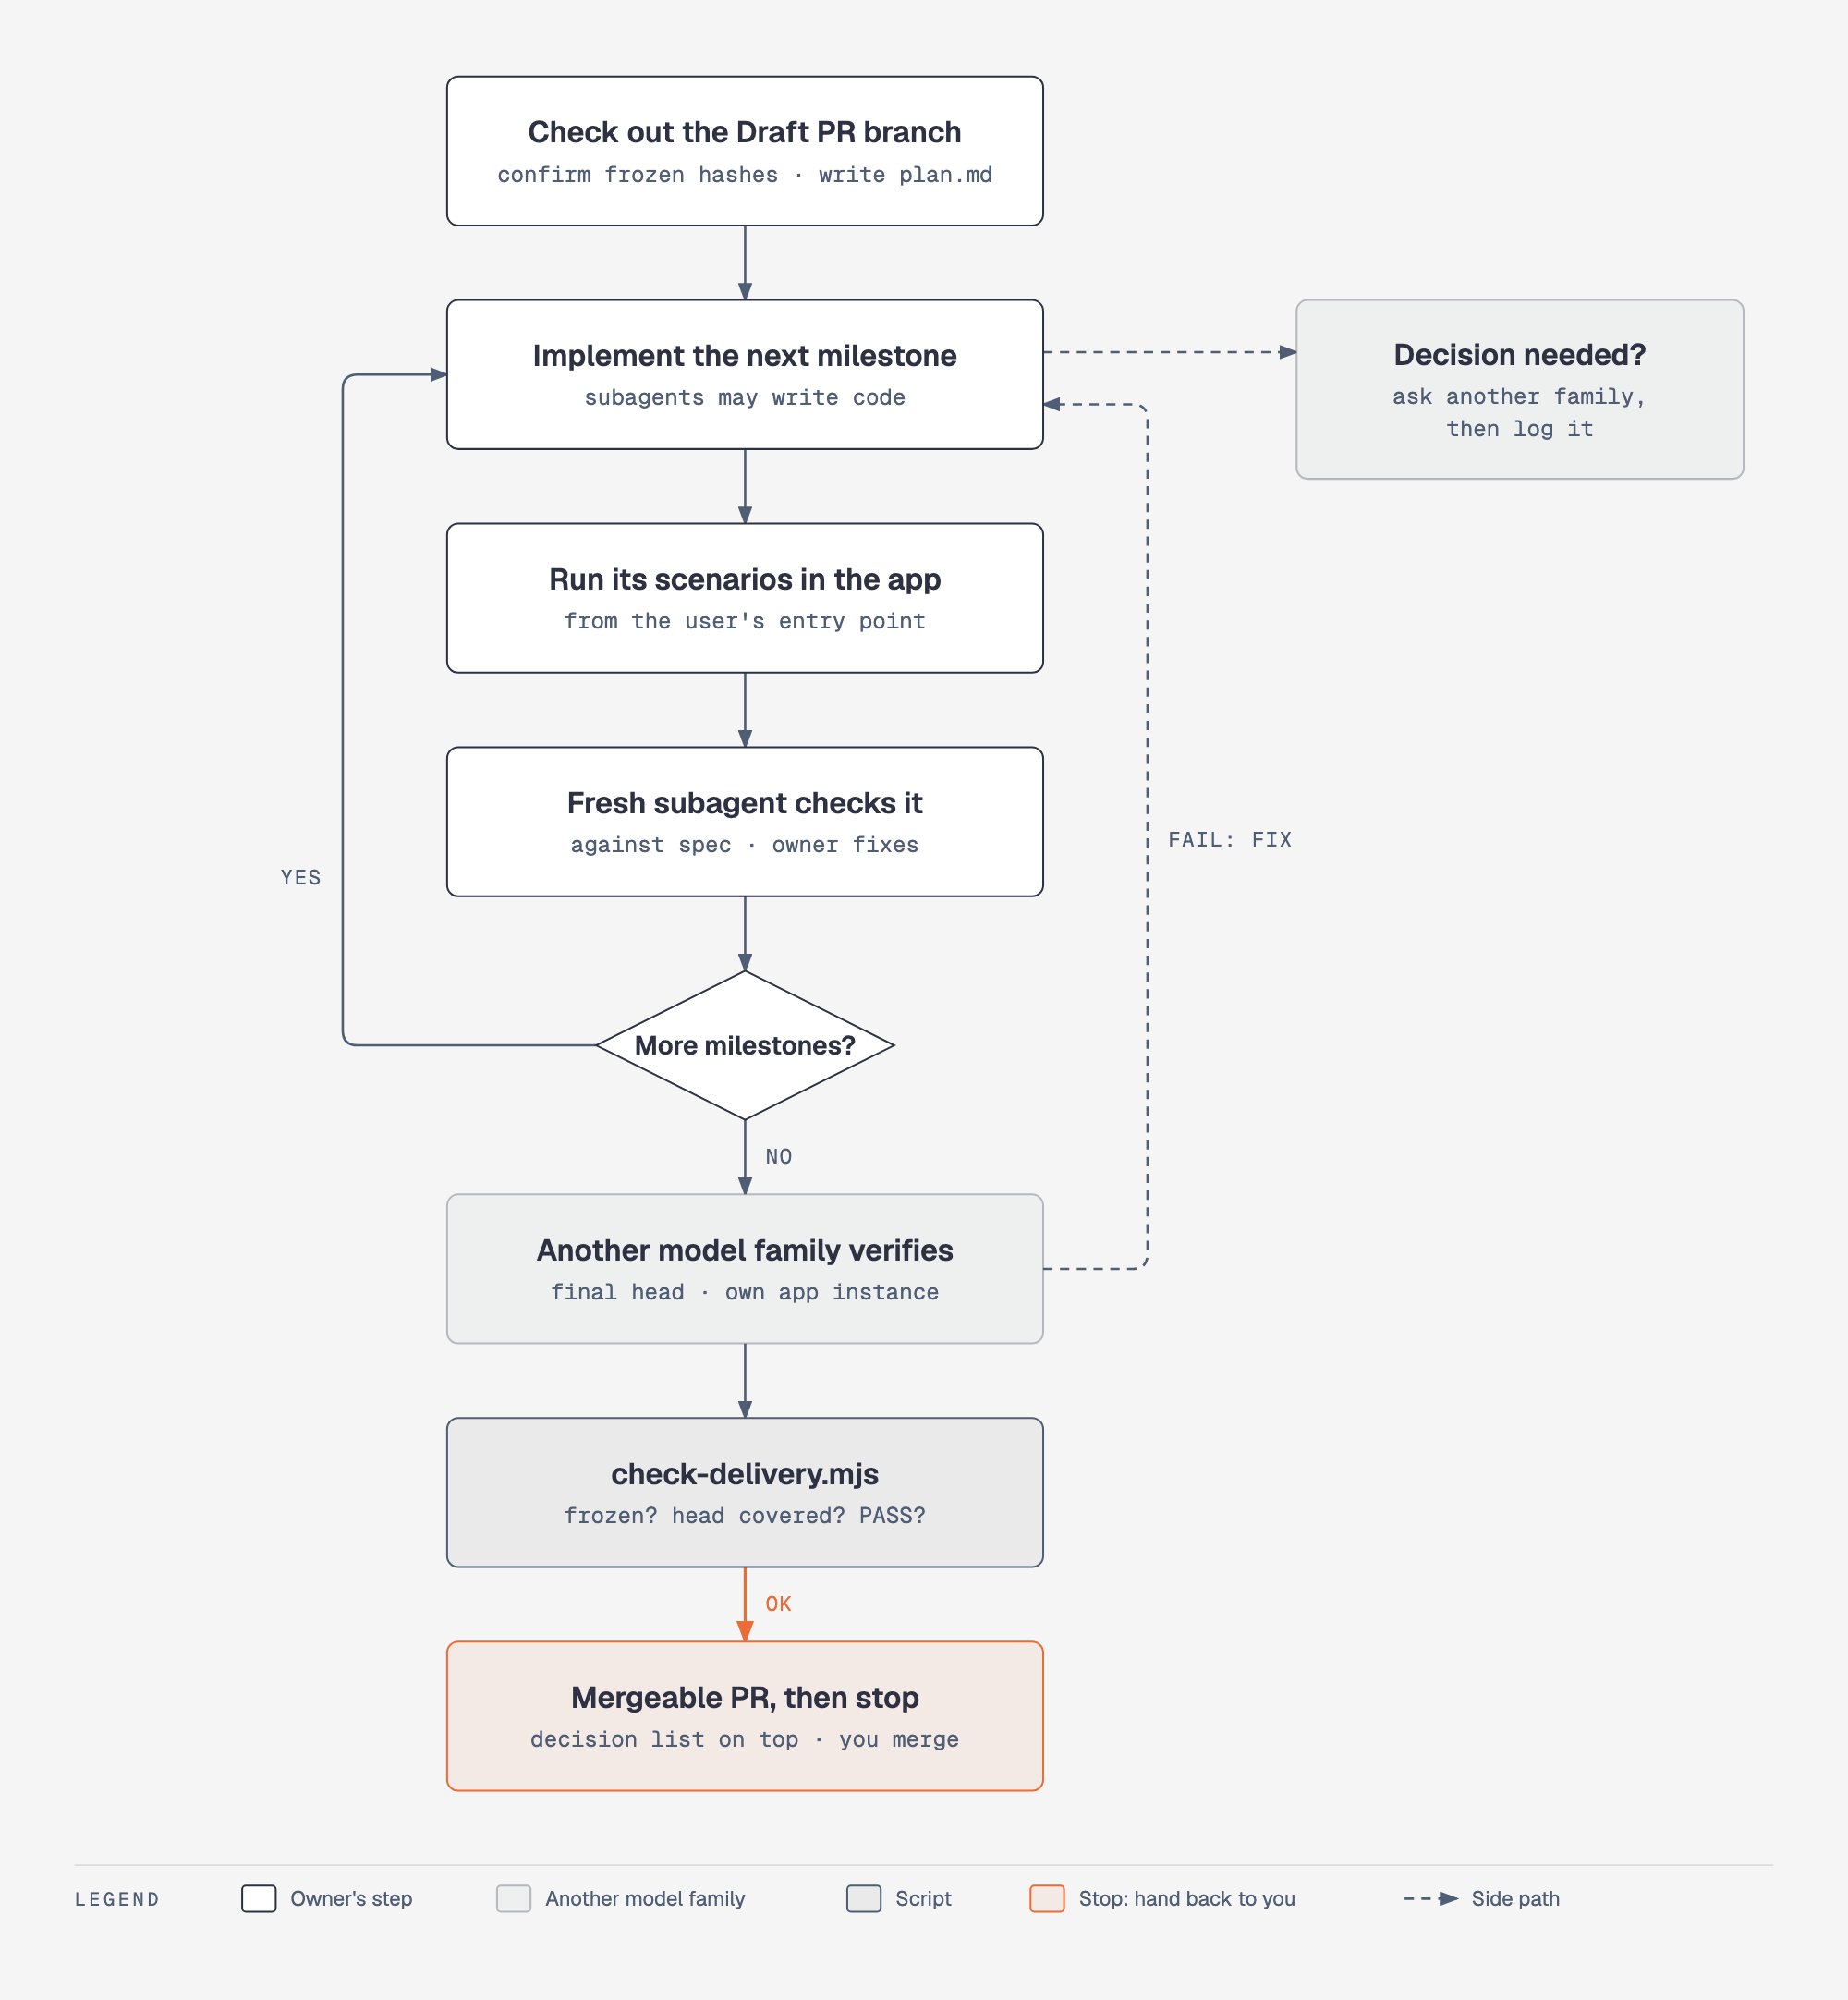
plan.md,跟代码一起提交,让新会话也能接着干。
- 每个里程碑都要实现并验证。 写完代码,在真实应用里运行对应场景,修复失败,再让一个全新的子 Agent 对照 spec 检查。
- 重要决定先听另一家模型的意见。 如果选择会影响用户,或影响检查结果如何判定,就请另一个模型家族给意见,不透露主 Agent 偏好的方案。然后作决定,继续推进。
- 把决定写成我能审阅的清单。 放在 PR 最上面,包括缺口、验证偏差和未完成项。每一项都说明,如果我推翻这个决定,哪些工作需要重做。冻结的 spec 和 verify 保持不变。
- 最后做独立验证。 另一个模型家族在自己的会话和应用实例里检查最终代码。它提出的代码质量问题,主 Agent 要修复,或者解释为什么不修。
谁来检查什么
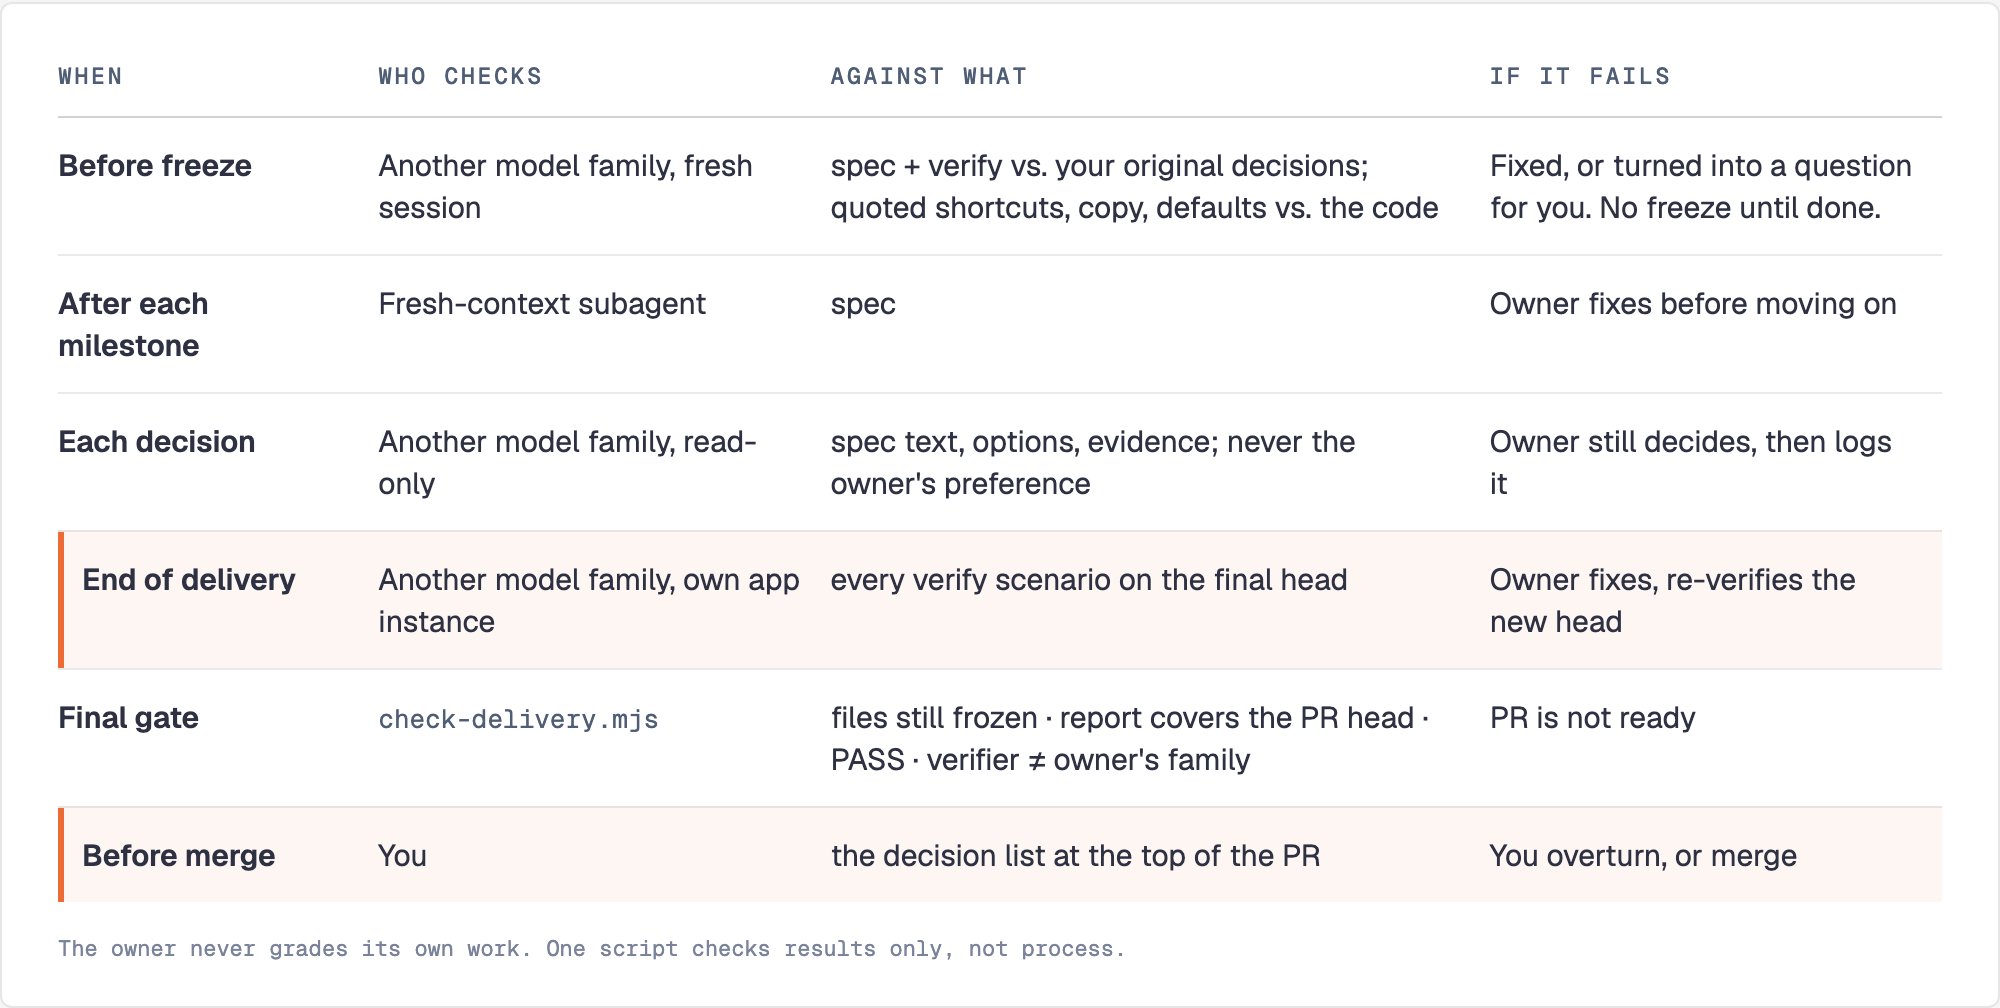
check-delivery.mjs 检查四件事:
spec.md和verify.md还是我确认过的版本;- 验证报告覆盖即将合入的代码;
- 验证结论是
PASS; - 验证者和主 Agent 来自不同模型家族。
七条原则
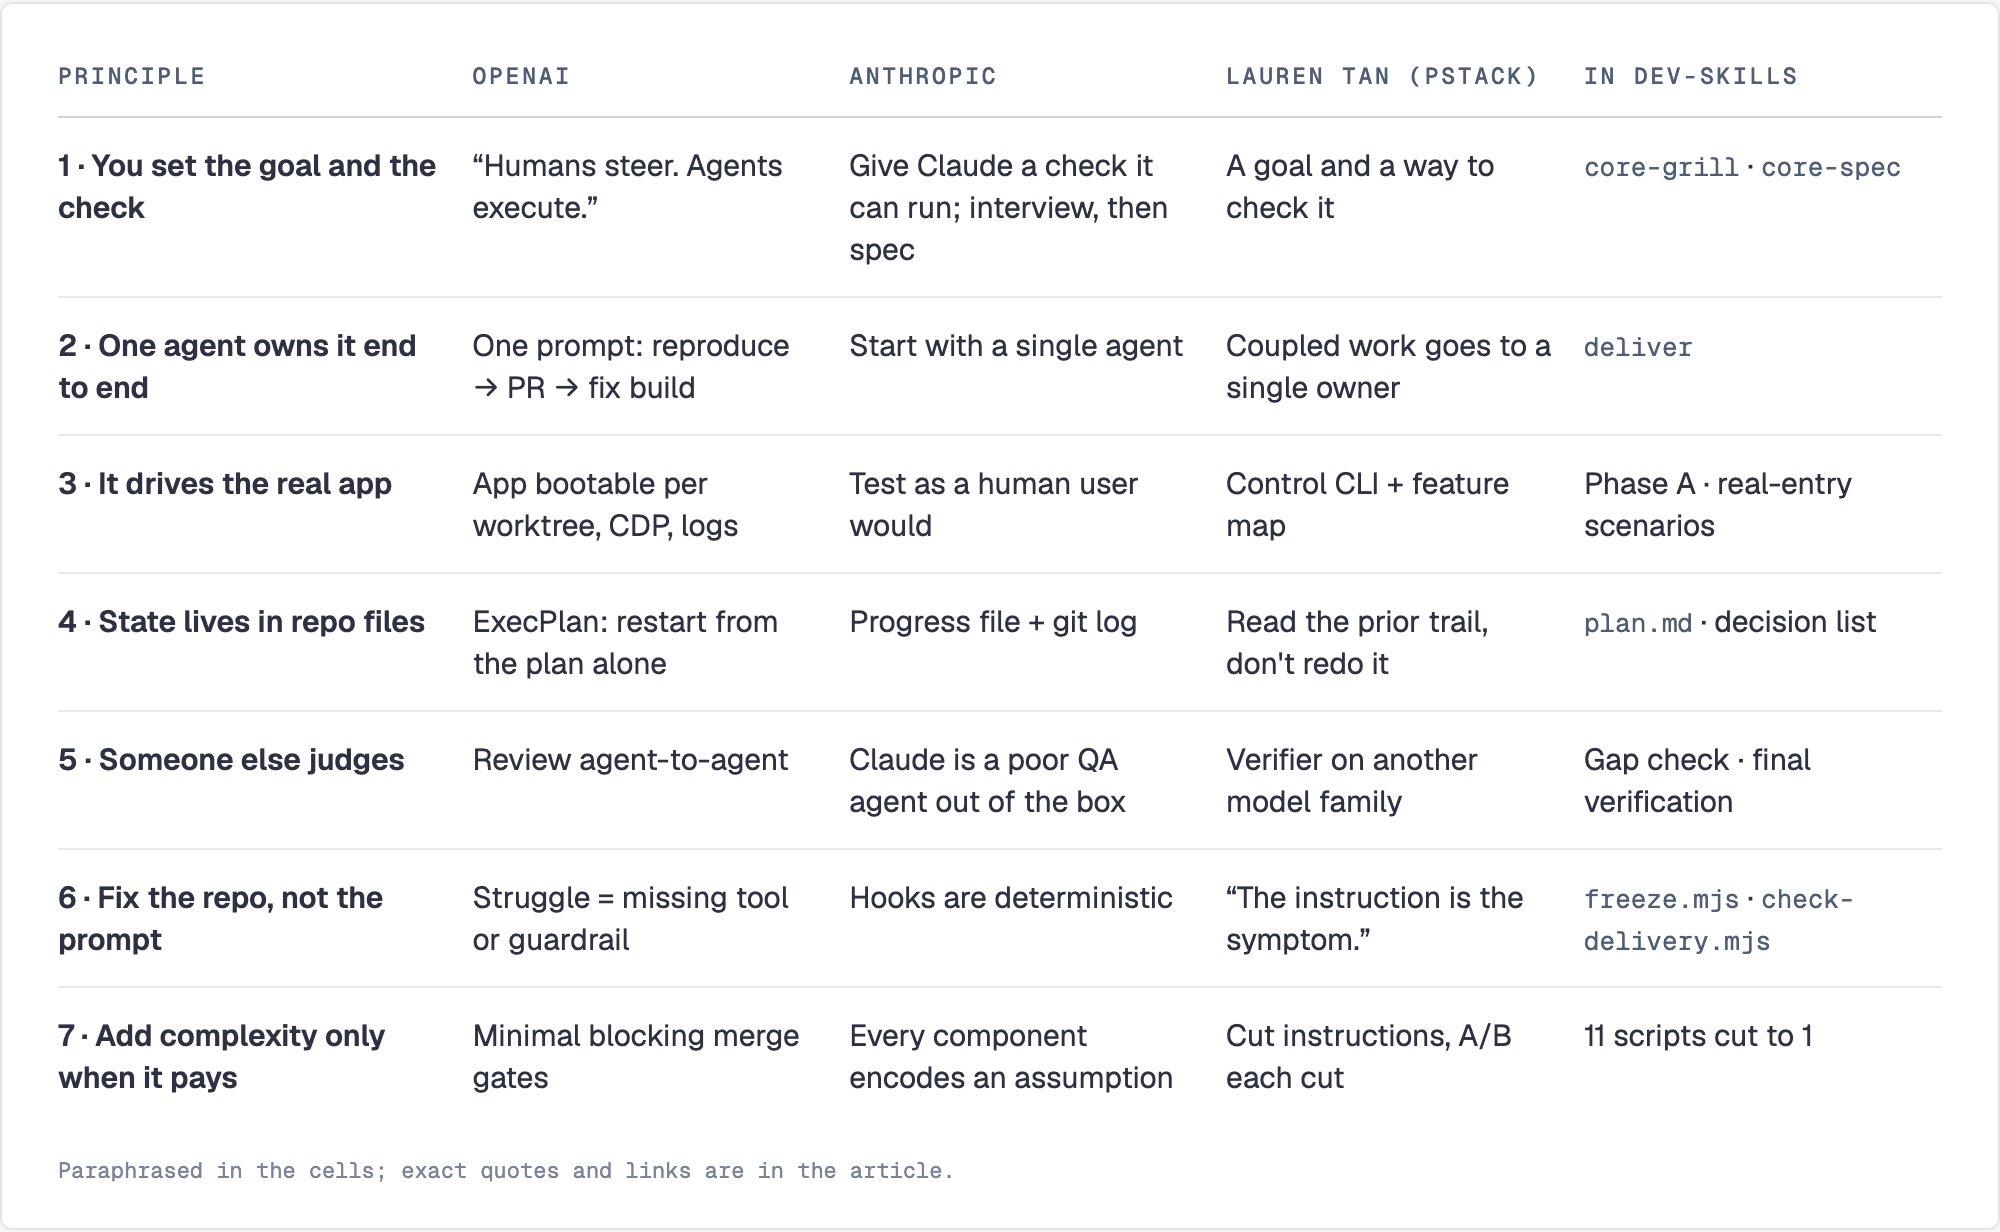
1. 你定目标和检查方式,然后走开
- OpenAI:“人类掌舵,Agent 执行。”(Harness engineering)
- Anthropic:“给 Claude 一个它能运行的检查……这决定了你是要盯着会话,还是可以走开。”(Claude Code best practices)
- Lauren Tan:“用你自己的话,给 Agent 一个目标,以及检查它的方法。”(pstack guide)
verify.md,放在代码之前,由另一家模型审阅,然后冻结。
2. 一个 Agent 从头负责到尾
- OpenAI:在他们自己的仓库里,给出一个提示词,Agent 已经能从复现 Bug 一直做到合并修复,“只在需要判断时才找人”。(Harness engineering)
- Anthropic:“一个设计得当、工具合适的单 Agent,能完成的工作远超许多开发者的预期。”(Building multi-agent systems)
- Lauren Tan:“代码耦合的工作,比如一个功能、一次迁移,交给一个负责人。”(pstack playbooks)
deliver:主 Agent 可以把编码、检查或场景运行交给子 Agent,但整合和决策仍由它负责。所以我把 Agent Lord 放到了一边。工作照样并行,只是由一个主 Agent 统一协调。
3. Agent 能运行、操作和观察真实产品
- OpenAI:“我们让应用能在每个 git worktree 中独立启动,这样 Codex 就能为每次改动启动并驱动一个实例。”(Harness engineering)
- Anthropic:他们发现,Agent 自己做时,单元测试过了,却没意识到功能从头到尾根本用不通。要求它“像人类用户一样完成所有测试”后,表现好了很多。(Effective harnesses for long-running agents)
- Lauren Tan:验证 Skill 是“关键基础设施,而不只是一个 Skill”。(The Complete Guide to pstack, Pt. 1)
verify.md 中的场景:从用户真正使用的入口运行,并记录旧代码的表现,避免写出一个怎么都不会失败的检查。
4. 计划和进度放在仓库文件里
- OpenAI:“应该始终能只靠 ExecPlan 就重新开始工作。”(Using PLANS.md for multi-hour problem solving)
- Anthropic:“仅靠上下文压缩还不够。”每次会话都先读进度文件和 git 日志。(Effective harnesses)
- Lauren Tan:“先读前面留下的记录,不要重做。”(pstack playbooks)
deliver 把进度写进 ExecPlan 格式的 plan.md,跟代码一起提交。有一次,我在 Claude Code 里跑的长任务被上游 API 错误打断,就换到 MCode 接手。新会话读了 plan.md 和 git 历史,不到半小时就找到了断点。
5. 做得对不对,由别人来判断
- Anthropic:“默认情况下,Claude 并不擅长做 QA。”他们的改进是:“把干活的 Agent 和判断结果的 Agent 分开,效果很明显。”(Harness design for long-running application development)
- OpenAI:“我们把几乎所有评审工作都交给了 Agent 之间互相完成。”(Harness engineering)
- Lauren Tan:“让一个工作单元的验证者和执行者使用不同的模型家族。”(pstack skills)
6. Agent 卡住时,修仓库,不只改提示词
- OpenAI:“Agent 遇到困难时,我们把它当作一个信号:找出缺少的东西——工具、防护机制、文档——再把它们补进仓库。”(Harness engineering)
- Anthropic:
CLAUDE.md中的指令“只是建议”,而 hooks “是确定性的,能保证动作发生”。(Claude Code best practices) - Lauren Tan:“那条指令本身就是症状。”(Encode Lessons in Structure)
freeze.mjs 固定 spec.md 和 verify.md,check-delivery.mjs 检查交付结果。D 阶段则把每次执行里的阻碍,变成仓库工具的改进。
7. 复杂度值得加时再加,一次加一点
- Anthropic:建议“先找到尽可能简单的方案,只有需要时才增加复杂度”。(Building effective agents)
- OpenAI:“优先做范围小的修正,不要每看到一个例子,就累积一条通用规则。”(Codex skill-creator)
- Lauren Tan:pstack 的 PR #419 删了 19 条指令。“每一处删减,都在会触及该指令的任务上做了 A/B 运行,比较有无这段文字的表现。”(PR #419)
deliver 的脚本从 3 个涨到 11 个,指令篇幅增加了约 70%。后来又删回 1 个脚本,指令缩到此前的一半以下。前后四天,这套工作流改了 32 个版本。
怎么用
先准备这些:- 两个模型家族。我在 MCode 里开发,检查交给 Codex,它和我在 MCode 里用的模型不是同一家;Claude Code 加 Codex 也可以。查漏和最终验证必须交给没负责实现的那一家,对应 CLI 要装好并登录。
- Node.js 24、git,以及
gh或glab。 - 一个 Agent 能在 worktree 里启动、操作和观察的应用,也就是 A 阶段。dev-skills 的仓库准备指南写了需要准备什么,Lauren 的 create-verification-skill 也可以作为起点。
core-grill提问,你回答,并确认最后的决定汇总。core-spec写 spec 和 verify,请另一家模型查漏。你读结果并确认,它再冻结文件、开草稿 PR。deliver推进到 PR 可以合入。你看 PR 顶部的决定清单,再合入。
/ 换成 $。
来源
OpenAI- Harness engineering: leveraging Codex in an agent-first world,Ryan Lopopolo(@_lopopolo)
- Using PLANS.md for multi-hour problem solving(ExecPlans)
- Codex skill-creator
- Effective harnesses for long-running agents
- Harness design for long-running application development
- Building effective agents
- Building multi-agent systems: when and how to use them
- Claude Code best practices
- The Complete Guide to pstack, Pt. 1
- pstack guide
- pstack skills and playbooks:poteto-mode(feature、orchestrate、session-pickup)、principle-encode-lessons-in-structure、create-verification-skill
- pstack PR #419
- X 上的演讲(2026 年 9 月)