

Boris Cherny 当时说,想试试用这种方式更好地管理 context。几个月过去,风向变了。Anthropic 的 Applied AI 团队最近发了篇文章,标题很直白:什么时候该把 subagent 收回主循环。他们在好几家企业的对比里看到:一个主 agent 配上 Skill,质量常常比「一个大 prompt 包打天下」和「subagent 架构」都好,成本和延迟往往还更低。 Dex Horthy(@dexhorthy)说得更不客气:subagent 被滥用,从 2025 年年中就开始了。它有用武之地,用对了杠杆很大;但社交媒体上的热度一直在鼓励大家开更多并行,而不是好好管 context。 对于 subagent:什么时候该拆,什么时候别拆,拆多了怎么收回来。我们在做 MiniMax Code(下文简称 MCode)的过程中,自己也一直在用它写代码,在这些问题上反复琢磨过,文中会顺带聊聊我们的思路。
Subagent 是用来管 context 的
Claude Code 团队的 Thariq 在《Session Management & 1M Context》里有个说法很好用:每一轮对话结束,都是一个分叉点。接下来你可以继续聊,可以 rewind 回到之前某条消息重来,可以 clear 开新会话,可以 compact 压缩历史,也可以把下一段活交给 subagent。除了「继续」,其余四个选项都是在管 context。 为什么要管?因为 context 越长,模型越容易被前面无关的内容带偏,这就是常说的 context rot。Thariq 提到,他们 1M context 的模型大概在 30 万到 40 万 token 时开始出现这种衰减,但跟任务关系很大,不是硬规则。 放在这个框架里看,subagent 就是一种隔离 context 的手段:开一个干净的 context 去干一段脏活,只把结论带回来。Thariq 给了一个判断方法:这段工具输出,我后面还要再看,还是只要一个结论?只要结论,才适合交给 subagent。 问题出在很多人把 subagent 当成了分工工具:一个团队一个 agent,一类问题一个 agent。出发点从「管 context」变成了「分地盘」,麻烦就来了。为什么拆多了反而变差
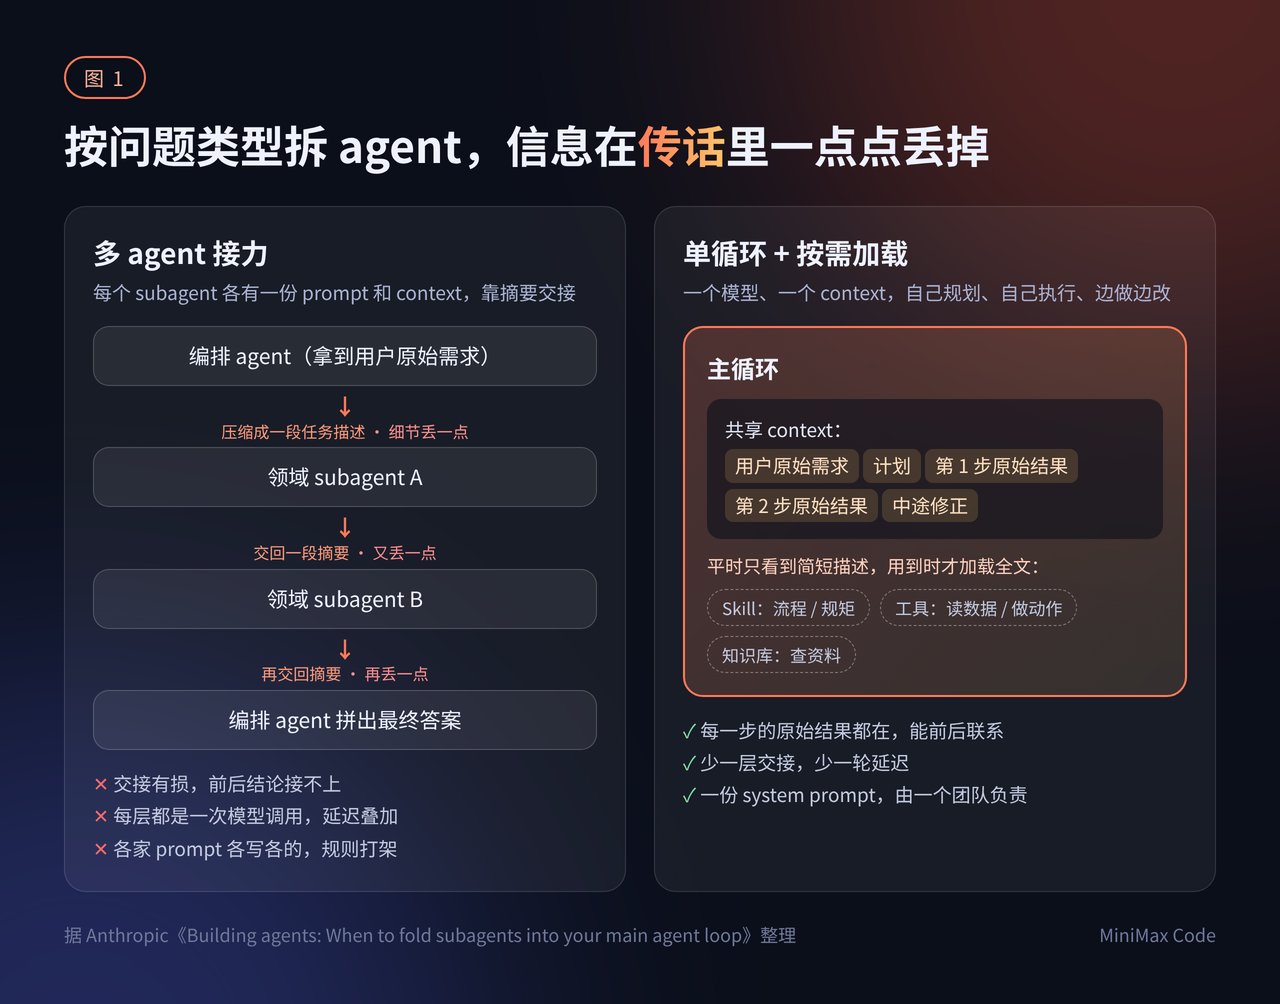
- 交接有损。按问题类型拆开后,agent 之间靠摘要来回传话,每交接一次就丢一点细节,文章管这叫「传话游戏」。
- subagent 越长越多。每个团队都上线自己的 subagent,最后堆出几百个功能重叠、没有统一标准、也没人负责的 agent。
- system prompt 变成缝合怪。每个团队往里加一句,规则互相打架,对外口径也不统一。
- eval 各管一段。每个团队只给自己那一小块写 eval,局部分数都好看,整体却没人负责,决策者看到的是被稀释过的分数。
- 延迟叠加。多一层 agent 就多一轮模型调用。有一家客户拿多 agent 方案和单循环做对比,单循环的运行速度大约是前者的 2 倍。
- 架构长成了组织架构图。每个团队、每类问题各配一个 subagent,这就是康威定律在 agent 上的翻版。
- 共享 context,答案更好。主 agent 看过前面每一步的原始结果,能把它们串起来,比拼几段 subagent 交回来的摘要更完整,也少了好几次有损的交接。
- 按需加载,context 不会撑爆。Skill 和工具平时只露出简短描述,用到时才加载全文(工具靠 tool search 延迟加载)。过去大家拆 subagent,最主要就是怕一个 prompt 塞不下,这条理由现在基本不成立了。Anthropic 说,他们把 Claude Code 面向较新模型的 system prompt 砍掉了 80% 以上,其中就包括把 Skill 和工具改成按需披露。
- 模型更强了。新模型在一个循环里能管的事情,比多数团队预想的多。harness 里写死的流程越多,换新模型时越施展不开。
什么时候仍然该用 subagent
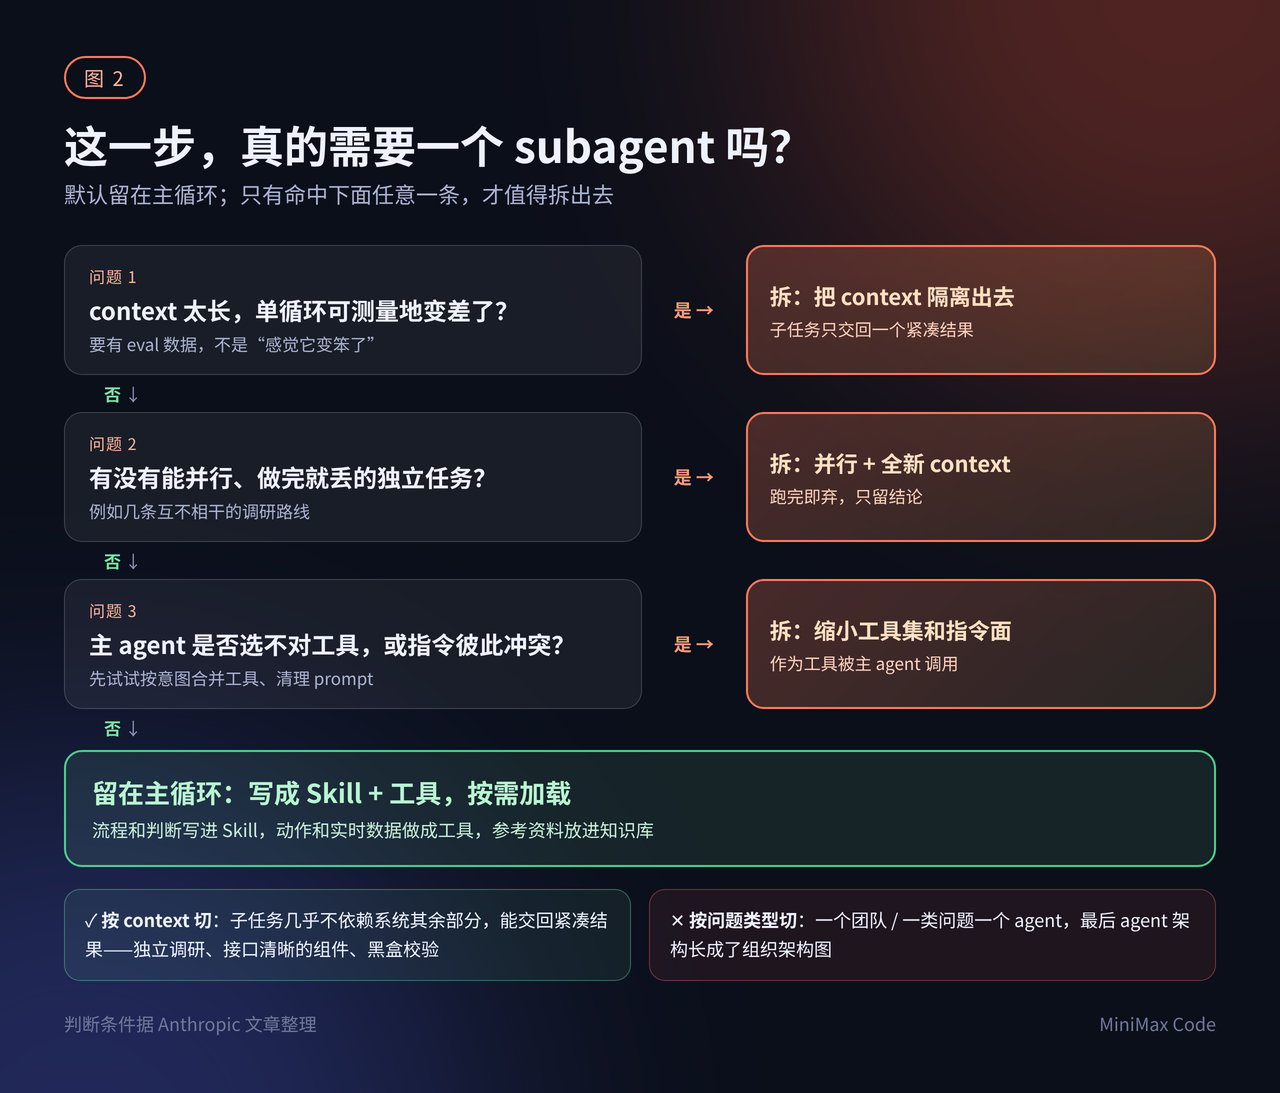
默认留在主循环,命中下面任意一条再考虑拆:- 单循环因为 context 膨胀,出现了可以测出来的效果下降。要有 eval 数据,光凭感觉不算。
- 有几件事要并行做,每件都需要干净的 context,做完就可以扔。比如几条互不相干的调研路线。
- 主 agent 选不对工具,或者 system prompt 里的指令互相冲突。
我们在 MCode 里的思路
Code Review:审查者要有自己的 context
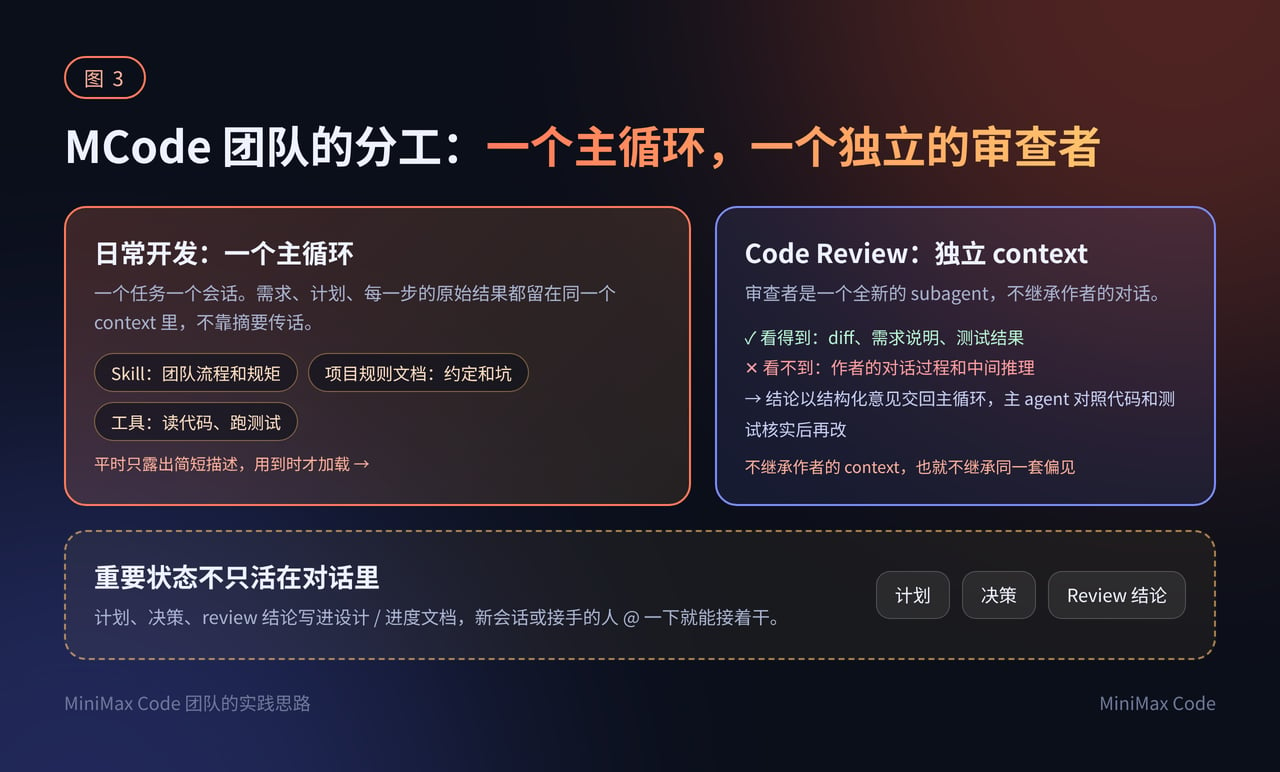
AI 写代码越来越快,代码质量靠什么把关,是我们做 MCode 时想得最多的问题之一。我们的思路是:写代码的 agent 和审查代码的 agent,不共用一份 context。 原因很朴素。写代码的 agent 一路上做了很多决定,也一次次说服了自己。审查者要是继承了这段对话,就会顺着同样的思路去看代码,作者漏掉的地方,它多半也会漏掉。让审查者从一个干净的 context 开始,它才能真正站在外面看这份改动。 具体来说,我们建议这样安排:- 只给审查者三样东西:diff、需求说明、测试结果。
- 不给作者的对话过程和中间推理。审查者要回答的是「这份改动有没有满足需求」,而不是「作者的思路讲不讲得通」。
- 结论以结构化意见交回主循环。比如逐条列出问题、位置和理由。主 agent 不照单全收,而是对照真实代码和测试逐条核实,确认成立了再改。
日常开发:一个主循环,Skill 按需加载
日常写代码,我们尽量一个任务一个会话,不额外拆 subagent。团队里反复用到的流程和经验写成 Skill 或项目规则文档,平时只露出一句描述,真用到时才加载全文。主循环始终看得到需求、计划和每一步的原始结果,不用靠摘要互相传话。 一个写代码的团队,通常值得沉淀下来的有这么几类:- 代码规范:命名、目录结构、错误处理这类每次都要遵守的约定。
- 发布流程:发版前要跑哪些检查、按什么顺序走。
- 内部库的用法和坑:哪个接口有隐藏前提、哪种写法踩过雷。
- 验证和测试步骤:改完代码怎么跑测试、怎么确认真的改对了。
重要状态,别只活在对话里
Dex Horthy 有句话我们很认同:重要的东西,不应该只存在于 context window 里。他的建议是把 context 和决策都沉淀到文档里,这样不管是 compact 之后接着干、开新会话,还是交给另一个人接手,都很顺。 做法并不复杂:长任务开始时就建一份设计或进度文档,把计划、关键决策、排除过的方案、review 结论随时写进去。新会话开始,或者换一个人接手,直接 @ 这份文档,agent 读完就能接着干,不用重新翻一遍聊天记录。 这样做还有个附带的好处:少了很多「为了保住 context 才拆 subagent」的冲动。状态已经在文档里了,会话可以放心地清空重来。手上已经有一堆 subagent,怎么收回来
很多团队的编排 agent 加一排专家 agent 已经在线上跑了,不可能一夜之间推倒重来。Anthropic 给的路径是分步走,我们觉得很实在:- 先建一个小的端到端 eval。10 个 golden example 就能起步。最好是一个中心团队维护一份共享的端到端集,各团队再随自己的 Skill 带一份小 eval。还没合并时,顺便看看路由准不准(有没有选对 subagent);合并之后,改看主 agent 有没有加载对 Skill、调对工具。
- 从最常用、耦合最紧的开始合。经常前后脚被调用的、读写同一份数据的、一个的输出是另一个的输入的,优先合成一个。
- 过渡期,先把 subagent 包成工具给主 agent 调。不用重写 subagent,还能先拿到一个 baseline。
- 一次只合一个。把它的 prompt 改写成 Skill,API 调用改成 MCP 工具,然后对比合并前后的 eval。
- 别只看总分,要看哪些任务翻转了。Anthropic 在一个客服 agent 样例上试过:合并一个 subagent 后延迟下降了,可一个原本能过的流程挂了。主 agent 自己拿着订单查询工具就直接回答,没去问物流专家送达日期。
- 每个任务多跑几次。上面那个问题,两次运行里只有一次暴露出来。生产里会连着跑的每一条 agent 链、每一条不能破的规则,都要有对应的 eval 任务。
/claude-api build-eval搭 eval/claude-api prompt-audit找出为老模型写、现在反而拖慢 agent 的指令/claude-api hillclimb对着 eval 迭代 Skill 和工具描述/claude-api cost-optimize分析成本和延迟。
一份拆分前的自查清单
- 这段子任务的中间输出,后面还要用吗?只要结论,才适合拆。
- 拆分的理由是 context,而不是「这是另一个团队 / 另一类问题」。
- 有 eval 数据证明单循环确实变差了,而不是凭感觉。
- 工具定义是不是已经超过 30 到 50 个?先按用户意图合并,用 tool search 延迟加载。
- 流程和规矩写成 Skill,动作和实时数据做成工具,参考资料放进知识库,按需加载。
- 计划、决策、review 结论已经写进设计或进度文档,而不是只留在对话里。
- 合并前后都跑了端到端 eval,看过翻转的任务,并且每个任务跑了不止一次。
结语
说到底,subagent 拆不拆只是表面,背后是同一件事:让对的信息在对的时候出现在 context 里。主循环里放该放的,Skill 和文档里存该存的,真正需要隔离的才交给 subagent。 模型还在快速变强,今天合理的架构,过几个月可能就不合理了。比起记住某一种结构,更值得记住的是那条原则:先量,一次只改一处,留下经得住检验的。 欢迎试试 MiniMax Code,也欢迎在 GitHub 上聊聊你们是怎么用 subagent、怎么管 context 的。我们很想听听不同团队的做法。参考资料
- Anthropic,Building agents: When to fold subagents into your main agent loop
- Thariq(@trq212),Using Claude Code: Session Management & 1M Context
- Dex Horthy(@dexhorthy),关于 subagent 滥用
- Dex Horthy(@dexhorthy),把 context 沉淀到文档,方便跨会话交接
- Boris Cherny(@bcherny),Claude Code 上线嵌套 subagent