

工具多了是好事,代价是 context。工具定义要占地方,工具结果要占地方,模型在一大堆长得差不多的工具里挑来挑去,也更容易挑错。
先看清楚:工具到底在吃哪几笔账
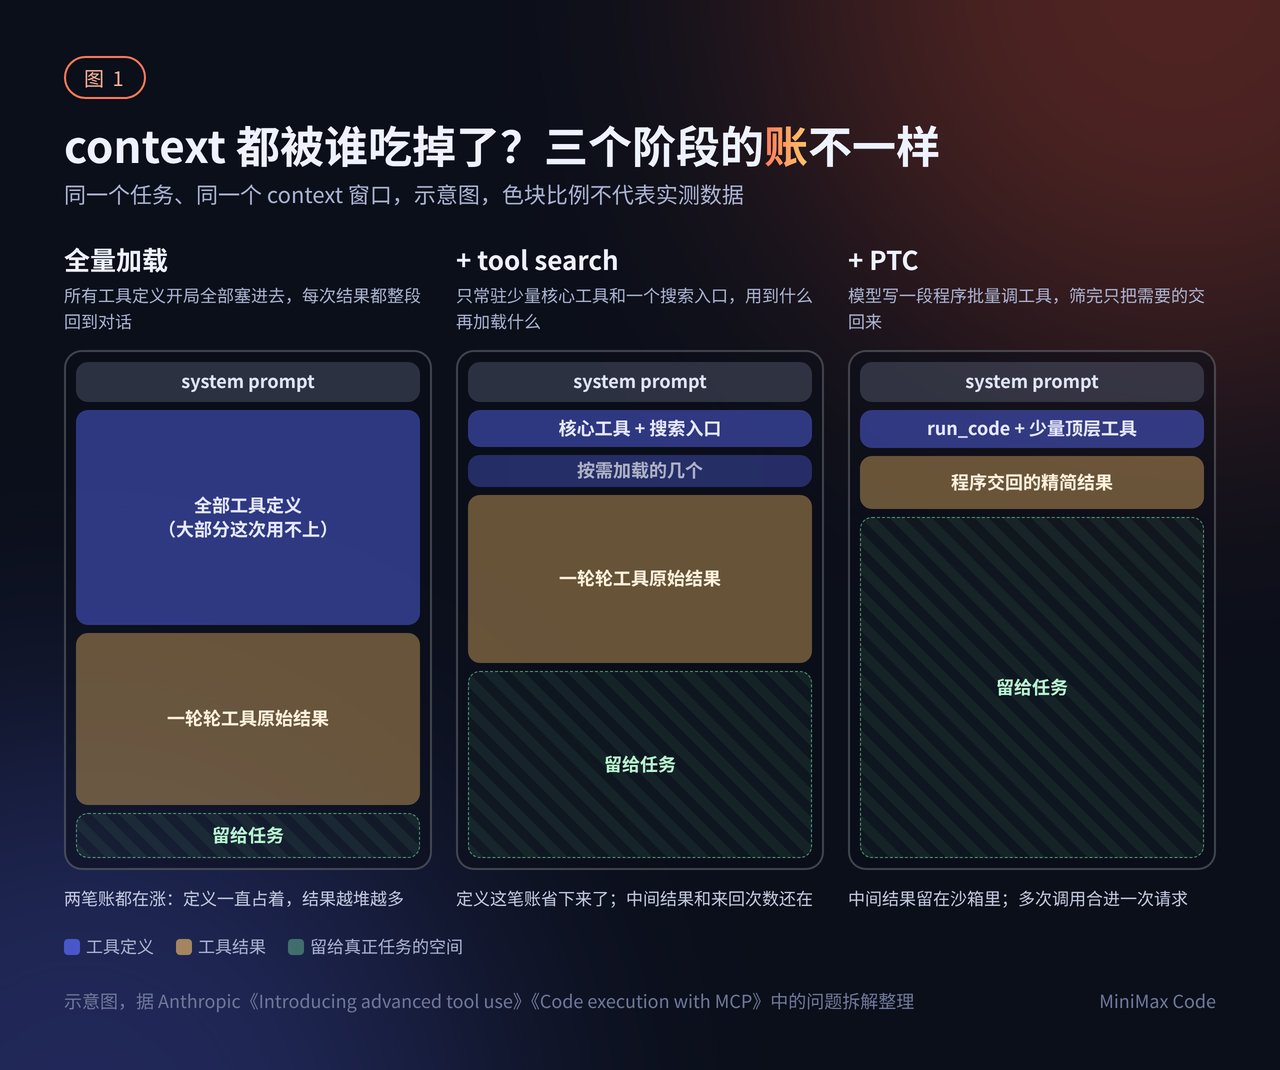
notification-send-user 和 notification-send-channel,模型就容易选错、传错参数。我们组里有同学说得很直接:一下子给模型七十来个工具,它就有点「脑容量爆炸」了。这和上一篇引用的 30 到 50 个工具的经验大体对得上。
账拆清楚了,后面几步就好理解了:tool search 主要省第一笔账,PTC 主要省第二笔。
第 0 步:先做减法
在上任何机制之前,最便宜的办法永远是少放一点。这一步没什么技术含量,但很多问题在这里就能解决一大半。- 按用户意图合并工具。别把底层 API 一比一映射成工具。「列出 issue」「按标签筛 issue」「按作者筛 issue」完全可以是一个带参数的工具。
- 名字和描述要能区分彼此。模型是靠名字和描述挑工具的。两个工具的描述如果读起来差不多,模型也分不清。顺手把返回格式写清楚,后面写程序调用时会用得上。
- 分组。OpenAI 的 tool search 文档建议用 namespace 把工具按领域分组,每组最好少于 10 个函数。分组清楚了,不管是人还是模型,找起来都快。
- 决定谁常驻。读文件、改文件、跑命令这类几乎每轮都用的工具,就该一直在。这一点后面还会再提。
第 1 步:延迟加载 + tool search
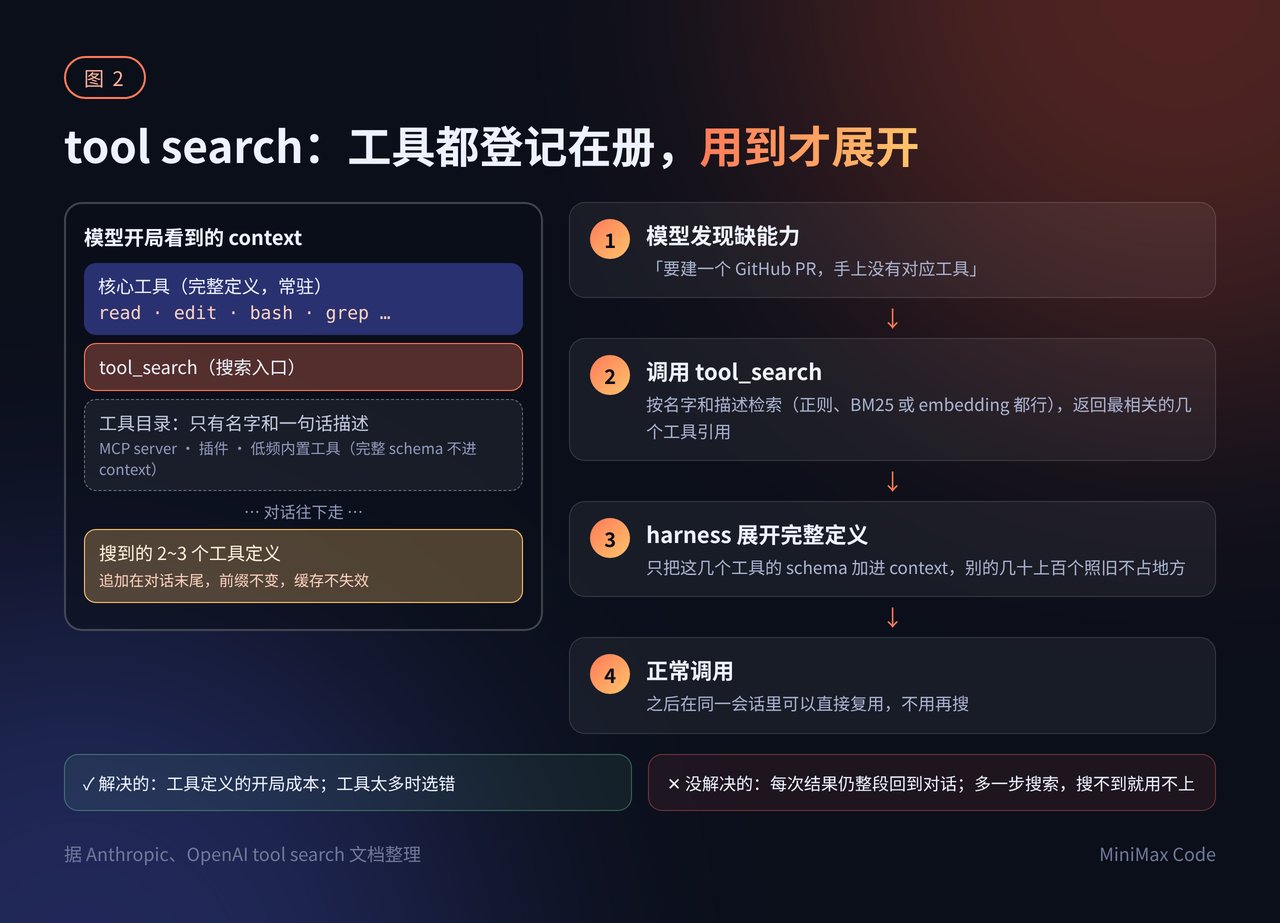
defer_loading: true,配一个 Tool Search Tool,搜索方式可以是正则、BM25,也可以自己实现。OpenAI 的 tool search 也类似,而且会把加载进来的定义放在 context 末尾,前面的前缀不变,prompt cache 不会因此失效。Claude Code 现在默认开启 tool search,Bash、Read、Edit 这类核心工具照常开局加载,其余按需发现;也可以设成 auto,等可延迟的工具定义占到 context 的 10% 再启用(文档)。
效果很明显。Anthropic 给的数据是,工具定义的开局开销能降约 85%;在他们的 MCP 评测里,Claude Opus 4 的准确率从 49% 提到 74%,Opus 4.5 从 79.5% 提到 88.1%(来源)。省 token 之外,选工具也更准了,因为模型面前的候选少了。
我们在 MCode 里怎么用
MCode 现在默认开启 tool search。具体是这么分的:- 核心内置工具常驻。读、写、改、搜索、跑命令这些高频工具一直带完整定义。为了省几百个 token 让模型每次先搜一下,不划算。
- 低频内置工具改为可搜索。平时用不上、偶尔要用的,进目录,用的时候再加载。
- MCP 工具按规模自动切换。工具数量少、定义体积小的时候照常加载;数量或体积超过阈值,就自动放进 tool search。用户不需要自己配置。
踩过的坑
- 搜不到就等于没有。tool search 把「能不能用上一个工具」变成了「能不能搜到它」。描述写得含糊,模型用的关键词对不上,这个工具就等于不存在。有时候模型还会反复换关键词搜,绕好几圈。所以前面说的「描述要能区分彼此」,到这一步更重要了。
- 别指望默认检索到处都好用。有人做过对比,某个 tool search 方案在干净的基准测试上和最好的配置打平,换到 525 个真实 MCP 工具上却落后了 19 个点(@kachar136)。工具集不同,检索效果差别很大,要在自己的工具集上测。
- 不是什么都适合放进去。如果某类工具的目录本身要每轮联网拉取,放进 tool search 反而可能拖慢首个 token。我们遇到过这种情况,后来把这类工具挪回了常驻区。
- 「在请求里」不等于「模型看过」。延迟加载的工具虽然出现在请求的工具列表里,但模型在某一时刻未必已经看过它的完整定义。排查问题、做评估时,要看的是模型当时实际能看到什么,而不只是请求里列了什么。
第 2 步:PTC,让模型写程序调工具
- Anthropic 的 Programmatic Tool Calling:在代码执行环境里调用工具,复杂研究任务平均 token 从 43,588 降到 27,297,降了 37%,几项评测的准确率还略有提升(来源)。他们另一篇文章里,把 MCP 工具组织成代码文件让模型按需读取,一个例子从 15 万 token 降到 2,000(来源)。
- Cloudflare 的 Code Mode:只留
search()和execute()两个工具,约 1,000 token 就覆盖了 2,500 多个 endpoint(来源)。 - OpenAI 的 Programmatic Tool Calling:模型写 JavaScript,在托管运行时里调用标记为可编程调用的工具。
- Pi 的 Codemode:在 harness 侧跑代码,每个工具可以单独配置成延迟加载或只能在代码里调用(来源)。
我们在 MCode 里的做法
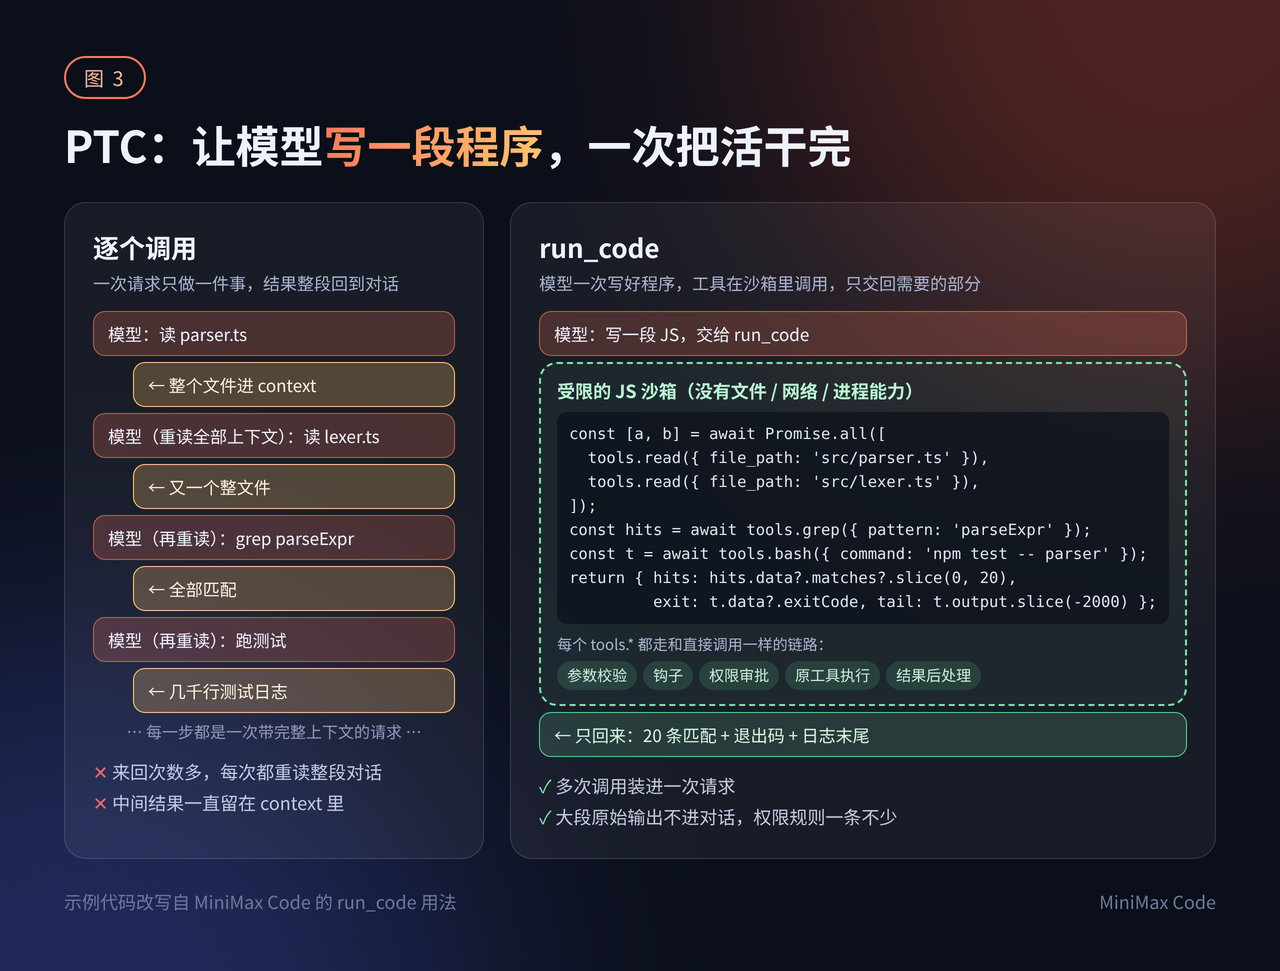
MCode 的 PTC 目前还是实验功能,仍在打磨。做法是给模型一个run_code 工具,模型写一段 JavaScript,程序里通过 tools.* 调用 agent 本来就有的工具。几个关键的设计取舍:
- 选 JavaScript。我们观察下来,模型写 JS 更稳定;而且小巧的 JS 引擎可以编译成 WASM,不用额外打包一个解释器。
- 程序本身什么都碰不到。代码跑在独立 worker 里的轻量 JS 引擎中,没有文件、网络、进程能力,能做的只有调用 agent 已有的工具。需要说明的是,它不是一个经过安全审计的强隔离沙箱,它守住的边界是:代码不能绕开工具自己去做事。
- 不绕过权限。程序里的每次
tools.*调用,都和直接调用走同一条链路:参数校验、钩子、权限审批、界面展示,一样不少。直接调用需要用户确认的操作,放进程序里照样要确认。 - 失败返回结果,而不是抛异常。模型写程序很少写 try/catch。一个工具失败就让整段程序崩掉,前面的工作全白做了。所以工具失败时返回一个带错误信息的结果,由程序自己决定怎么办。
踩过的坑
- 只「提供」不够,要真的把工具挪进去。一开始我们把
run_code和所有原生工具一起放在顶层,模型几乎不用它,开销反而变大了。后来把大部分工具挪到只能在程序里调用,模型才开始真正写程序。 - 不是所有工具都该挪。顶层只留几类:要和用户交互的、改变会话状态的、得先读完结果才能决定下一步的(比如加载 skill、tool search)、浏览器和发布类的,以及派 subagent 的。我们试过把派 subagent 也放进程序,结果它被用得明显少了。
- 模型直接调了被挪走的工具怎么办?给它一个提示,告诉它这个工具要在
run_code里调。我们发现,语气明确的提示比客气的建议管用得多。 - 长命令就在程序里等着。看起来把长命令丢到后台、再轮询更「聪明」,其实每次轮询都是一次带完整上下文的请求,反而更贵。直接在程序里阻塞等结果更省。
- 依赖工具名的功能会悄悄失效。一个工具挪进程序以后,所有按这个工具名触发的逻辑,比如某些提醒、统计,就再也看不到它被调用了,而且不会报错。挪之前最好把这类依赖都翻一遍。
- 中间环节可能弄丢参数类型。我们遇到过请求链路上的某个环节,对没有在顶层声明的工具做了类型转换,参数类型就丢了。最后的修法是根据工具自己的 schema 把类型还原回来。
- 程序也会写错。报错的程序里,最常见的是引号和转义问题,尤其是在 JS 字符串里拼 shell 命令的时候。
三步怎么选,能不能一起用
Anthropic 的建议也是按瓶颈分层叠加:定义太大,上 tool search;中间结果太多,上 PTC;参数总传错,给工具加用例。反过来,只调一次的简单操作、或者模型必须亲眼看到中间结果才能决定下一步的场景,就别硬塞进程序里。
两者完全可以一起用,而且我们觉得应该一起用。tool search 把工具目录理清楚,PTC 在这个基础上把调用装进程序。有一个细节要注意:OpenAI 的文档明确说了,tool search 在顶层运行,不能在程序里面调用,所以要先把需要的工具搜出来加载好,再开始写程序。这也是为什么在 MCode 里,tool search 留在顶层。
一份自查清单
- 先算账:工具定义占了多少 context,一个任务里工具结果占了多少,平均要来回多少次。
- 工具已经按用户意图合并过,名字和描述读起来能彼此区分,返回格式写清楚了。
- 高频核心工具常驻,低频工具和大批 MCP 工具延迟加载。
- 在自己的工具集上测过 tool search 的召回,而不是只看别人的基准。
- 需要每轮联网拉目录的工具,确认不会拖慢首个 token。
- 上 PTC 时把工具真正挪进程序,并且想清楚哪些必须留在顶层。
- 程序里的工具调用和直接调用走同一套权限、钩子和展示。
- 工具失败返回错误结果,不抛异常;工具尽量返回结构化数据。
- 翻一遍所有按工具名触发的逻辑,确认挪进程序后不会悄悄失效。
- 前后都跑端到端 eval:既看得分,也看请求次数和 token。
写在最后
回头看这三步,其实和上一篇说的是同一件事:让对的信息在对的时候出现在 context 里。精简是少放,tool search 是晚放,PTC 是把不需要模型看的东西留在外面。 还有一点体会:每一步都是在给下一步打基础。工具目录理不清,tool search 就搜不准;tool search 没做好,PTC 也很难做好。别想着一步到位,按瓶颈一步步来,每一步都量一量。 欢迎试试 MiniMax Code,也欢迎在 GitHub 上聊聊你们是怎么管工具和 context 的。我们很想听听不同团队的做法。参考资料
- Anthropic,Introducing advanced tool use on the Claude Developer Platform
- Anthropic,Code execution with MCP: Building more efficient agents
- Anthropic,Building agents: When to fold subagents into your main agent loop
- Claude Code 文档,Tool search
- Cloudflare,Code Mode: the better way to use MCP
- Cloudflare,Code Mode: give agents an entire API in 1,000 tokens
- OpenAI 文档,Tool search
- OpenAI 文档,Programmatic tool calling
- Earendil(Pi),You Said No MCP!(X 帖子)
- @kachar136,tool search 在真实 MCP 工具集上的对比
- @jasonfesta,PTC 只有在程序先过滤结果时才省 context