

这一篇换个角度,聊时间维度上的 context:会话越来越长以后怎么办。
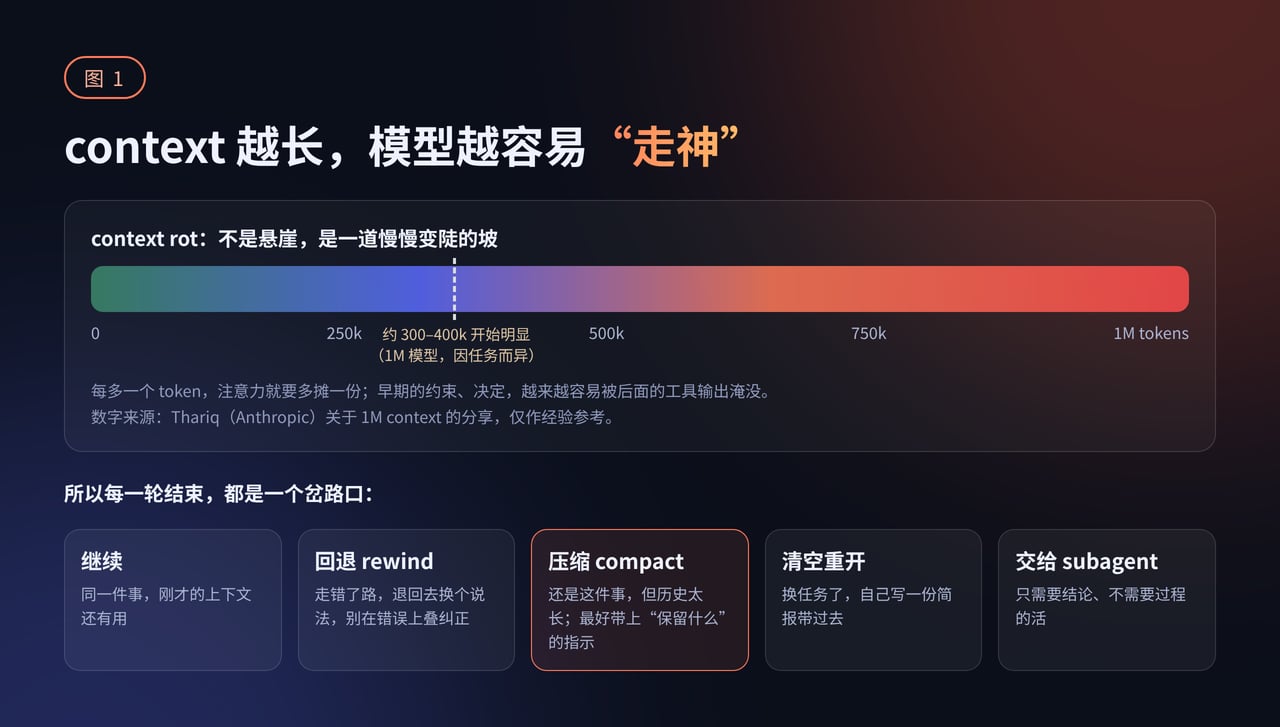
为什么会话越长,agent 越笨
compaction 是什么,各家怎么做
compaction 说白了,就是在 context 快满时,让模型把到目前为止的对话总结一遍,然后用这份摘要替换原来的历史,接着往下干。它是有损的:摘要再好,也不可能保留原文的所有细节。 几家公开的做法大同小异,差别在细节上:- Claude Code:快满时自动压缩(auto-compact),也可以手动
/compact,并且能带指示,比如/compact focus on the auth refactor, drop the test debugging。按 Anthropic 的说法,压缩时会保留架构决定、未解决的 bug 和实现细节,丢掉重复的工具输出,压完之后带着摘要和最近访问的 5 个文件继续。Claude Code 团队的 Lydia Hallie 在 X 上补充过:1M 模型默认要到约 967K 才自动压缩,这意味着之前的每条消息都很大;可以用/autocompact 400k让它早点压。她还介绍了空闲压缩:会话闲置、prompt cache 快过期(约 1 小时)之前先压一次,用户回来时只需要重新处理那份摘要。 - Claude API:服务端 compaction 支持按需触发、到 token 阈值自动触发,或者换成你自己的摘要逻辑;可以保留最近几轮原文,也可以自定义摘要 prompt,文档原话是“当默认摘要漏掉了后面某一轮需要的东西时”用。另外还有更轻的 context editing:不做摘要,只按规则清掉旧的工具调用和结果。Anthropic 把清理工具结果称为最安全、最轻量的一种压缩。
- OpenAI:Responses API 的 compaction 可以设阈值自动触发,也有单独的 compact 接口。一个明显的区别是,压缩产物是加密的、不透明的,“不是给人读的”,里面带着之前的状态和推理;压缩后的窗口会保留所有用户消息,后面跟一个压缩条目。
- Cursor:在《Dynamic context discovery》里提了两个思路。一是长工具输出直接写到文件里,agent 需要时再去读,这样被迫摘要的次数少了;二是摘要时给 agent 留一个完整聊天记录文件的引用,摘要漏掉的细节可以回去搜。
- 能不摘要就不摘要(先清工具结果、长输出落文件)
- 非摘要不可时尽量可控(带指示、自定义 prompt、保留最近原文)
- 摘要丢了还能找回来(原始记录留在磁盘上)
compaction 会在哪儿出问题
压缩用得多了,问题也就看得清楚了。大致有这么几类: 一是丢决定、丢约束。会话开头说的“不要动公共 API”“测试必须用真实数据库”,在几十轮之后的摘要里很可能只剩一句话,甚至没了。Claude Code 的文档说得很直接:只在对话里给过的指令,压缩后可能就丢了;写进项目根目录 CLAUDE.md 的规则,压缩后会从磁盘重新读一遍再注入。 二是细节被概括掉。Thariq 举过一个例子:一段很长的调试之后触发自动压缩,摘要概括了调试过程;接着你说“现在去修一下 bar.ts 里那个 warning”,可那个 warning 恰恰在摘要里被省掉了。根本原因是模型压缩时猜不到你下一步要干什么。他还提到一个容易被忽略的点:因为 context rot,模型压缩的那一刻,恰恰是它状态最差的时候。建议是,有了 1M 窗口,就别等自动压缩,主动压,并且说清楚接下来要做什么。
我们内部讨论这个问题时有一句话印象很深:“记忆也是个摘要。”换句话说,指望靠写一份更好的摘要去纠正上一份摘要,往往行不通。
模型看到的 context 和用户在界面上看到的对话记录是两回事,压缩只该改前者,不该让用户的历史凭空消失。
该压的压,该丢的丢,该落盘的落盘
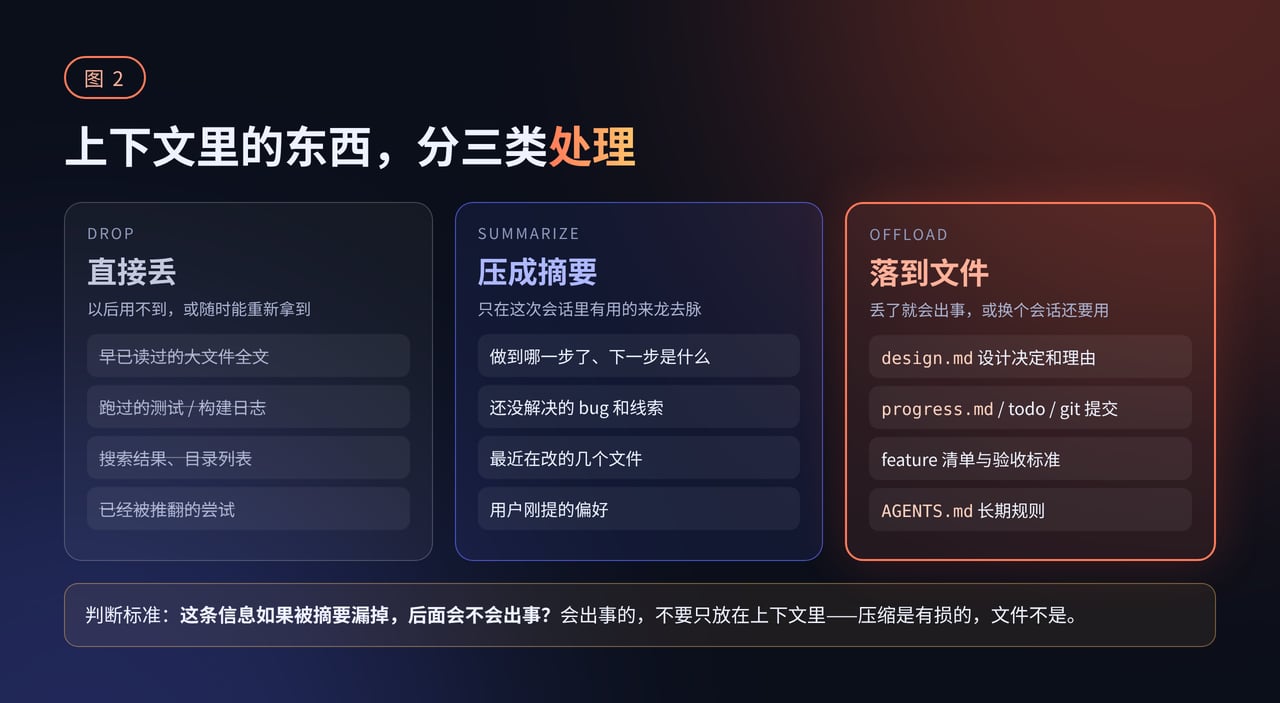
- 直接丢:用不上或者随时能重新拿到的。读过的大文件、跑过的测试日志、搜索结果、已经推翻的尝试。这些优先清,用 context editing 或者清理工具结果就够了,用不着劳驾摘要。Thariq 判断要不要交给 subagent 的标准也适用于这里:这段工具输出我以后还要看,还是只要结论?
- 压成摘要:只在这次会话里有用的来龙去脉。做到哪了、下一步是什么、还有哪些没解决的 bug 和线索、最近在改哪几个文件。这正是压缩擅长处理的部分。
- 落到文件:丢了会出事,或者换个会话还要用的。设计决定和理由、进度、待办、验收标准、长期规则。
什么时候该开新会话,而不是压缩
压缩适合“还是这件事,只是历史太长”的情况。下面几种情况,开新会话往往更好:- 换任务了。Thariq 的经验法则是“新任务开新会话”。上一个任务的调试过程、工具输出,对下一个任务基本是噪音。有灰色地带,比如刚实现完一个功能,接着写它的文档,这时候保留上下文可能更省事。
- 压缩过好几次,开始漂移了。与其在漂移的摘要上继续叠,不如让 agent 先写一份交接文档:目标、已经做出的决定、当前进度、下一步、要注意的坑,然后清空,带着这份文档开新会话。Thariq 管这叫自己写简报:比压缩多花点功夫,但带过去的正是你认为重要的东西。
- 方向错了。这时候该回退,而不是压缩。压缩会把错误的尝试也概括进摘要里。
compaction 和 memory 怎么分工
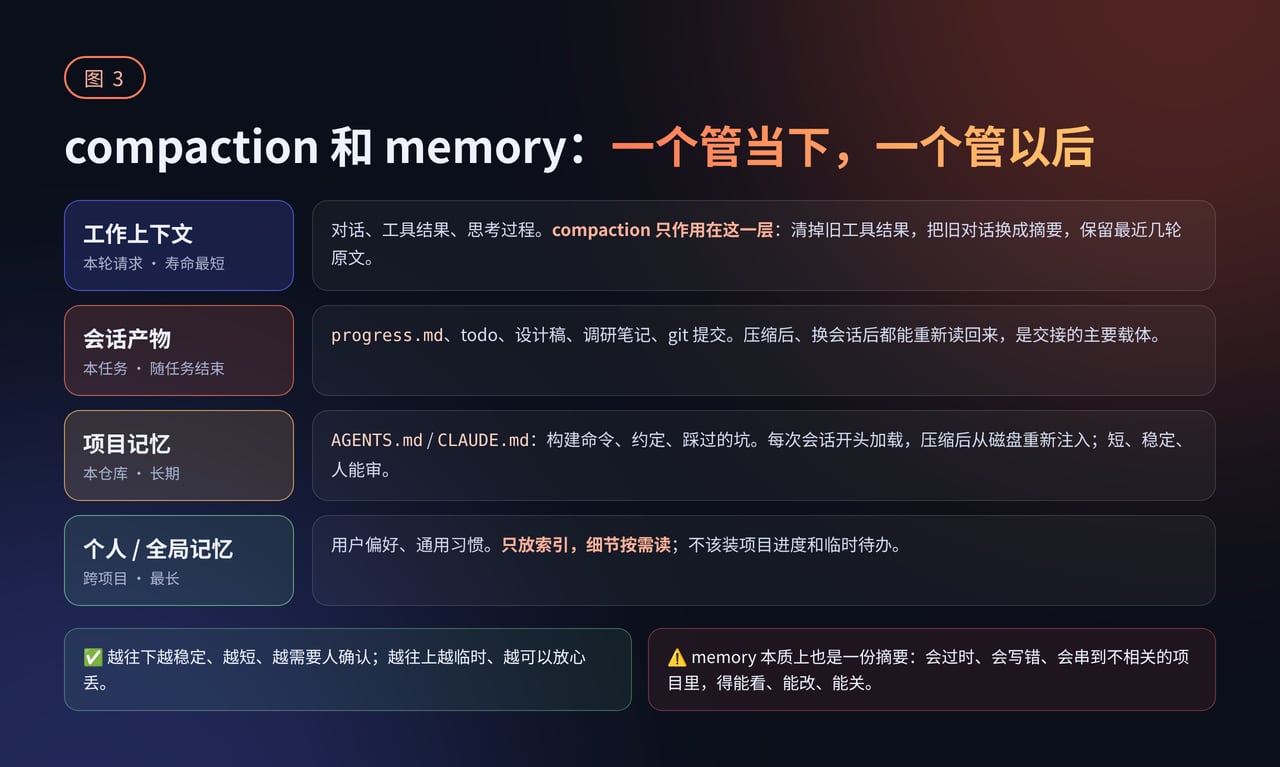
- 工作上下文:当前请求里的对话、工具结果、思考过程。compaction 和 context editing 只作用在这一层。
- 会话产物:进度文件、todo、设计稿、调研笔记、git 提交。跟着任务走,任务结束就可以归档,是交接的主要载体。
- 项目记忆:
AGENTS.md/CLAUDE.md这类文件,写构建命令、代码约定、踩过的坑。每次会话开头加载,压缩后也会重新注入。Claude Code 建议这个文件控制在 200 行以内,并且只在同一个错误犯了两次之类的情况下才往里加。 - 个人 / 全局记忆:跨项目的偏好和习惯。Claude Code 的 auto memory 是一个思路:
MEMORY.md只当索引,会话开始只加载前 200 行或 25KB,具体内容放在各个主题文件里按需读;能从代码里推出来的东西不记。
AGENTS.md。
memory 也是摘要,会错,所以要能看、能改、能关。Claude Code 文档有一句提醒:CLAUDE.md 是 context,不是强制执行;必须执行的规则应该交给 hook。记忆同理,它是给模型的提示,不是真相,最好是人能直接打开的纯文本文件。
Anthropic 在发布 context editing 和 memory tool 时给过一组他们自己的内部评测数据:在一个 agentic 搜索评测上,memory 加 context editing 比基线提升 39%,只用 context editing 提升 29%;在一个 100 轮的网页搜索评测里,token 消耗降了 84%。具体数字和场景强相关,但方向很清楚:两者配合,比单靠一个强。
我们在 MCode 里怎么做,踩过哪些坑
说几点我们自己的体会,主要是原则层面的:- 把压缩时机交给用户。默认的自动压缩触发点会给模型输出和摘要留出余量,但很多用户希望更早压,让每次请求小一点、快一点。所以我们加了一个配置项
contextManagement.compactionTriggerAt(PR #493),可以按窗口比例或者绝对 token 数设置。这个值只能让压缩提前,不能推后,避免请求越过模型的输入上限。 - 压缩是 harness 的内部动作,不该占用户的预算。比如设了最大步数的场景,压缩过程不应该算作一步;压缩改的是模型看到的 context,不该改用户看到的对话记录。
- 让模型知道会有压缩。我们见过 agent 在长任务做到一半时说“上下文快用完了,下一轮再继续”,仿佛不知道系统会帮它压缩。harness 应该在提示里讲清楚:context 会被自动管理,进度要落到文件里,然后放心继续干。
- 用户真正想要的,常常是交接而不是压缩。不少用户的习惯是让 agent 写一份交接文档再开新会话。这说明可控、可读的交接,比一份看不见的摘要更让人放心。
几种手段放在一起看
自查清单
- 旧工具结果有没有先清掉,而不是一上来就整段摘要?
- 会话里定下的关键决定和约束,有没有写进文件,而不是只活在对话里?
- 手动压缩时,有没有告诉模型接下来要做什么、哪些要保留?
- 自动压缩的触发点有没有给输出和摘要留足余量?压缩失败时会话还能不能继续?
- 压缩请求能不能命中缓存?压缩频率会不会让缓存频繁失效?
- 换任务时有没有开新会话?压缩多次之后,有没有改用交接文档?
- AGENTS.md / CLAUDE.md 是否足够短,只放长期稳定的规则?
- 记忆有没有按作用域分开?临时进度和待办有没有挡在长期记忆之外?
- 记忆超出预算时,截断是否显眼,最重要的规则是否一定会被加载?
写在最后
回头看,前两篇讲的是空间上怎么省 context,这一篇讲的是时间上怎么管 context,道理是相通的: 欢迎试试 MiniMax Code,也欢迎在 GitHub 上聊聊你们是怎么管长会话、怎么用压缩和记忆的。我们很想听听不同团队的做法。参考资料
- Anthropic,Effective context engineering for AI agents
- Anthropic,Effective harnesses for long-running agents
- Anthropic,Managing context on the Claude Developer Platform
- Claude API 文档,Compaction
- Claude Code 文档,How Claude remembers your project
- OpenAI 文档,Compaction
- Cursor,Dynamic context discovery
- Thariq(@trq212),Using Claude Code: Session Management & 1M Context
- Lydia Hallie(@lydiahallie),auto-compact 的触发点与 /autocompact、空闲压缩
- Dex Horthy(@dexhorthy),把上下文都落到产物文档里、长会话在哪儿收尾
- MiniMax Code,PR #493:contextManagement.compactionTriggerAt