

先想一个问题:Agent 跑一条 bash 命令,要不要等它跑完?
一个大家都见过的场景
让 agent 帮你「把服务跑起来看看」,它敲下npm run dev,然后就没有然后了。dev server 本来就不会退出,agent 就一直等在那里。
这不是个别现象。X 上有人列 agent 最常见的几种翻车方式,第二条就是它:「卡住的进程。一个永远不返回的 dev server 或 watcher,循环就干坐在那儿。」
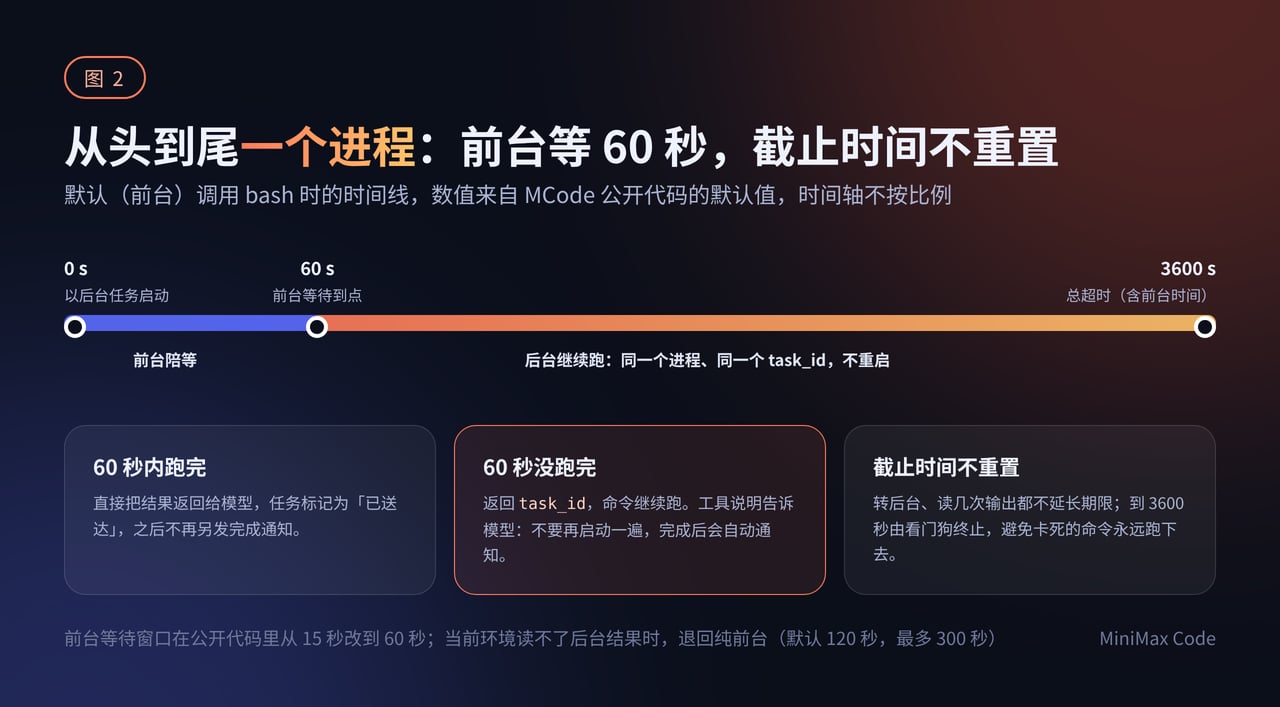
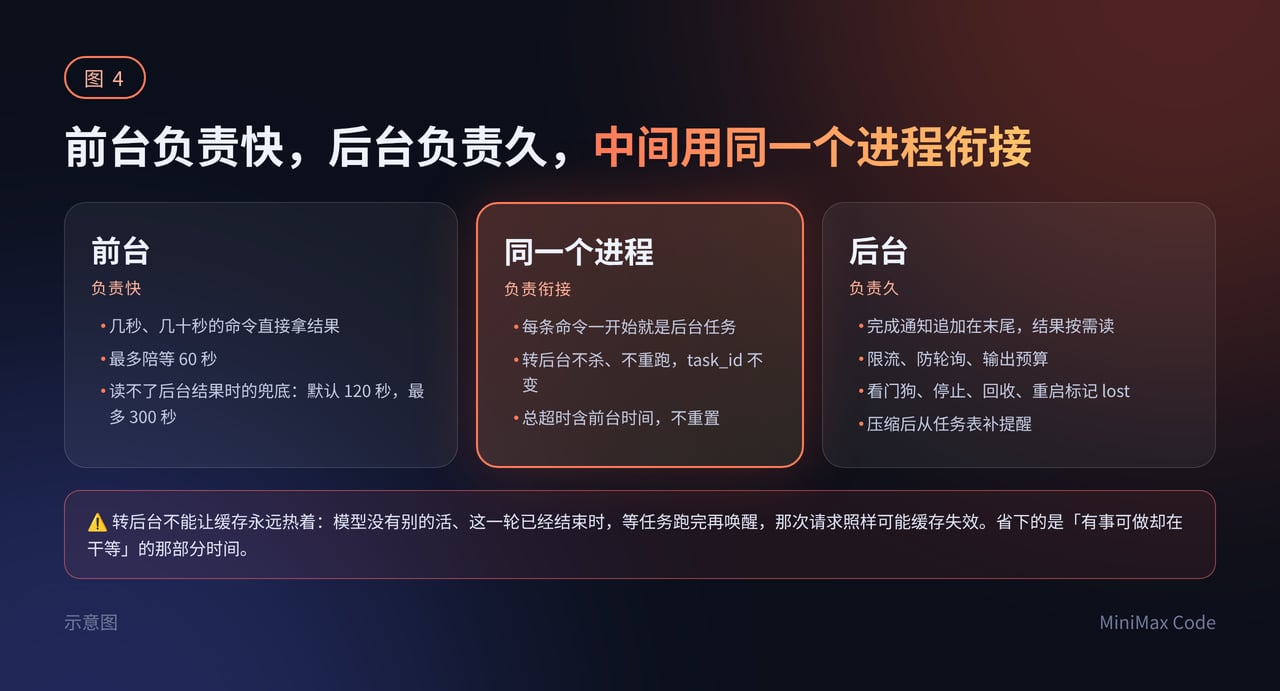
最直观的做法是等命令结束,把输出塞回去,模型接着想。为了不卡死,再加一个超时。这条路在 MCode 里一直都在,现在是兜底:默认超时 120 秒,最多 300 秒。
对 ls、git status 这种几百毫秒的命令,这就是最优解。但 dev server、全量测试、完整构建,要么不会结束,要么要跑好几分钟。超时一到就杀掉,等于白跑一趟。
别人是怎么做的
主流做法已经很一致了:让长命令去后台跑。 以 Claude Code 为例,它的文档写得很清楚:后台命令会立刻返回一个任务 ID,输出写进文件,Claude 之后再去读;用户可以按Ctrl+B 把正在跑的命令挪到后台(有人在 X 上把这个快捷键专门整理过);命令跑到超时还没结束,会自动转到后台,而不是被杀掉。
这回答了「dev server 怎么办」:它去后台跑,agent 继续干活。但还有一个问题没回答:
一条命令跑 3 分钟、能正常结束,为什么不干脆把超时调长,老老实实等它?
为什么不能干等:缓存会过期
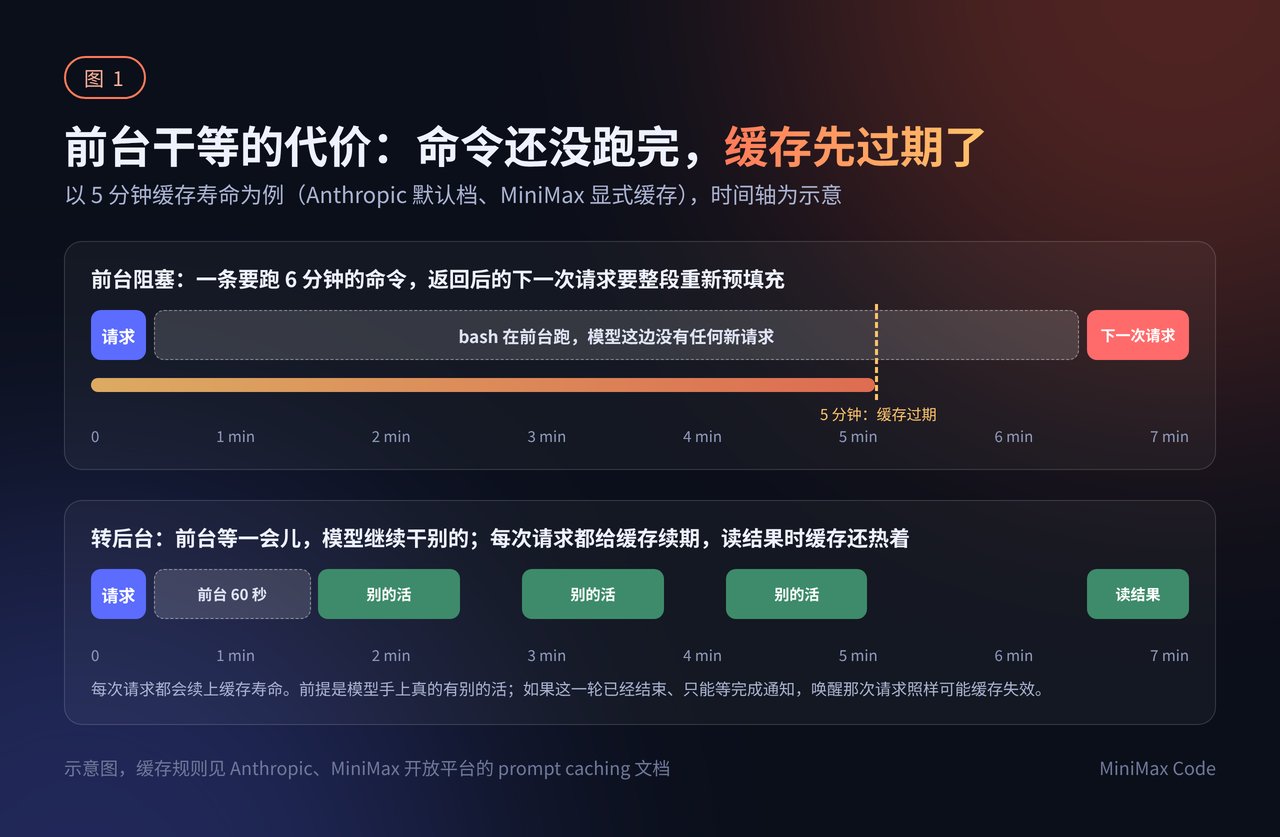
- Anthropic 默认缓存 5 分钟,每次命中会续期。寿命从请求开始算,模型生成的时间也算在里面。另有 1 小时档,但写入价是普通输入的 2 倍。
- OpenAI 的缓存时长按模型不同,从闲置 5–10 分钟到更长的档位都有。
MCode 的做法:前台等一会儿,等不到就转后台,不重跑
和 Claude Code 一样,MCode 的 bash 有run_in_background 参数:模型觉得命令会很久,就让它在后台跑,立刻拿回一个 task_id。
光靠这个不够,因为模型经常预判不准。它以为几秒的事,结果跑了十分钟。所以我们又加了一层「自动转后台」。关键实现只有一点:每条前台命令从一开始就作为后台任务启动,前台只是陪它等一会儿。
下一个问题:跑完了,模型怎么知道?
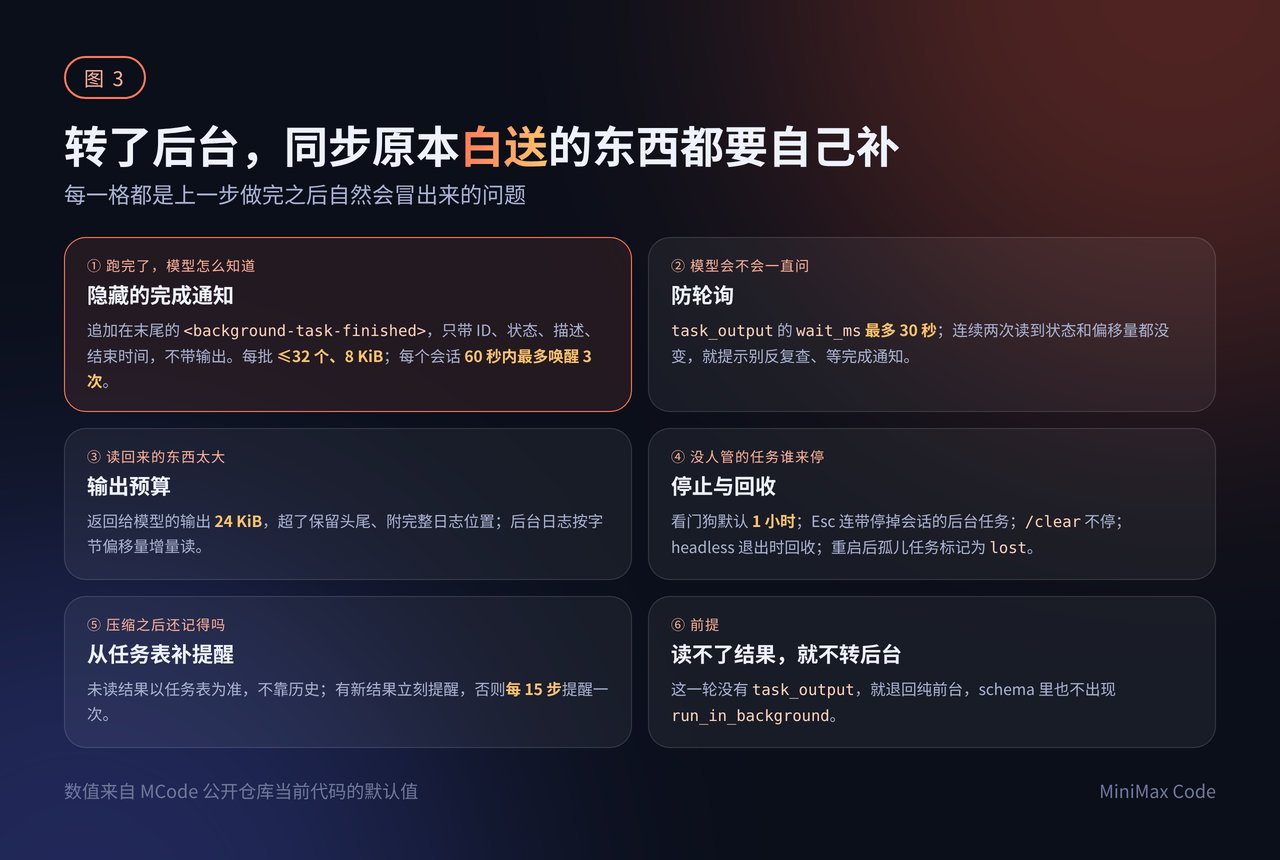
后台命令跑完后,运行时会往会话里塞一条隐藏消息<background-task-finished>,把会话唤醒。这条消息只带 task_id、状态、描述和结束时间,不带输出。模型要看结果,得自己调 task_output。
这么做有两个原因。
一是通知要短:每批最多 32 个任务、8 KiB,描述超过 256 字节会截断。
二是通知是追加在末尾的新消息,不会改动已经缓存的前缀。
如果一个会话里同时有很多任务在完成,通知也要限流:每个会话 60 秒内最多唤醒 3 次,超出的会延后。投递失败按 1、2、5 秒重试,之后退避到 60 秒,最长 5 分钟。
再下一个问题:模型会不会自己一直问?
会,而且很贵。有了 task_id,模型很容易写出这样的循环:查一下,还没完,再查一下……每查一次都是一次完整的模型请求,带着整段上下文。 这件事别家也踩过。有人在 X 上转述过另一个开源 agent 的一次修复:一个重度用户的 agent 一个月里对一个安静的后台进程反复发了约 1,900 次等待调用,每次都是一轮二十多万 token 的请求;改成自动通知后,小模型的 token 消耗降了 45%。方向和我们的判断一致:要让结果自己回来,而不是让模型去问。
- 工具说明直接写明:完成后会自动通知,不要频繁轮询。
task_output可以带wait_ms阻塞等新输出,但最多 30 秒,超了按 30 秒算。- 如果模型连续两次读到的状态和偏移量都没变,返回结果里会附一句提示:要等新输出就带上
wait_ms,别反复立刻检查,先去干别的,等完成通知。
读回来的东西太大怎么办?
前台返回给模型的输出有 24 KiB 的预算,超了就保留开头和结尾,中间省略,并附上完整日志的位置。后台任务的输出写进日志文件,task_output 按字节偏移量增量读,模型可以只读新增的部分。日志如果没写全,也会单独告诉模型,不让它把不完整的输出当成全部。
没人管的后台任务,谁来停?
后台任务最怕没人管。用户对这一点的感受很直接。X 上有 Claude Code 用户直接喊话: 「停掉主 agent 的时候,能不能把后台任务和子 agent 一起停掉」。 用户按了停,就是希望一切停下来;但用户只是离开一下,又不希望长任务被白白杀掉。我们按场景分开处理:- 看门狗:显式后台命令如果没给超时,默认最多跑 1 小时。这个值在公开代码里从 30 分钟调到过 1 小时。
- 用户按 Esc 停止:会连带取消这个会话拥有的后台 bash 和子 agent(#381)。被停掉的任务结束时,不会再把会话唤醒。结果仍然留着,下一轮会通过提醒告诉模型。
/clear或切换会话:只停当前这一轮,后台任务继续跑。用户离开不等于用户不要了。- headless 单次执行退出时:会把这个进程里的后台 bash 全部回收,否则一个长循环会让 CLI 一直挂着不退。
- 进程重启:启动时会把上一个进程留下、已经没有主人的任务标记为
lost,不会让它们永远显示「运行中」。
上下文被压缩之后,还记得有结果没看吗?
上下文太长时,compaction 会把早期历史压成摘要。如果「有个后台任务完成了还没看」只记在历史里,压缩一次就丢了。 我们的做法是:未读结果的事实来源是任务表,不是历史。每轮准备请求时,运行时从任务表里查有没有已结束但没读过的任务,有就补一条<background-task-completion-reminder>,列出最早的几个。有新任务结束时会立刻提醒,否则模型每干 15 步提醒一次。模型一旦成功读过 task_output,这一轮就不再提醒。
最后一个前提:读不了结果,就别转后台
只有这一轮的工具里有task_output,bash 才允许转后台。否则就退回开头那种纯前台模式(默认 120 秒,最多 300 秒),连 run_in_background 参数都不出现在 schema 里。转了后台,模型却没有办法把结果拿回来,那还不如老老实实等。
回头看
给做 agent 的几条自查
这些都在 MiniMax Code 的公开仓库里,主要在
packages/local-runtime/src/background-task/ 和 packages/agent-tools/src/desktop/ 下面。
参考资料
- Vibecodepipe(@Vibecodepipe),agent 常见翻车方式:永不返回的 dev server
- Claude Code 文档,Background Bash commands
- johnnynelai(@johnnynelai),Claude Code 的 Ctrl+B 等快捷键整理
- Anthropic 文档,Prompt caching
- MiniMax 开放平台,Anthropic 兼容接口的缓存、Prompt Caching
- OpenAI 文档,Prompt caching
- ZYPHER(@ZypherHQ),等构建、等测试太久,缓存会过期
- wallabytoken(@wallabytoken),一次 2.3 小时会话里的「停顿税」
- jus_eng_njainam(@jus_eng_njainam),反复等待调用与改成自动通知后的效果
- 7izzyx(@7izzyx),希望停止主 agent 时连带停掉后台任务
- MiniMax Code,PR #381:停止会话时连带停止后台任务