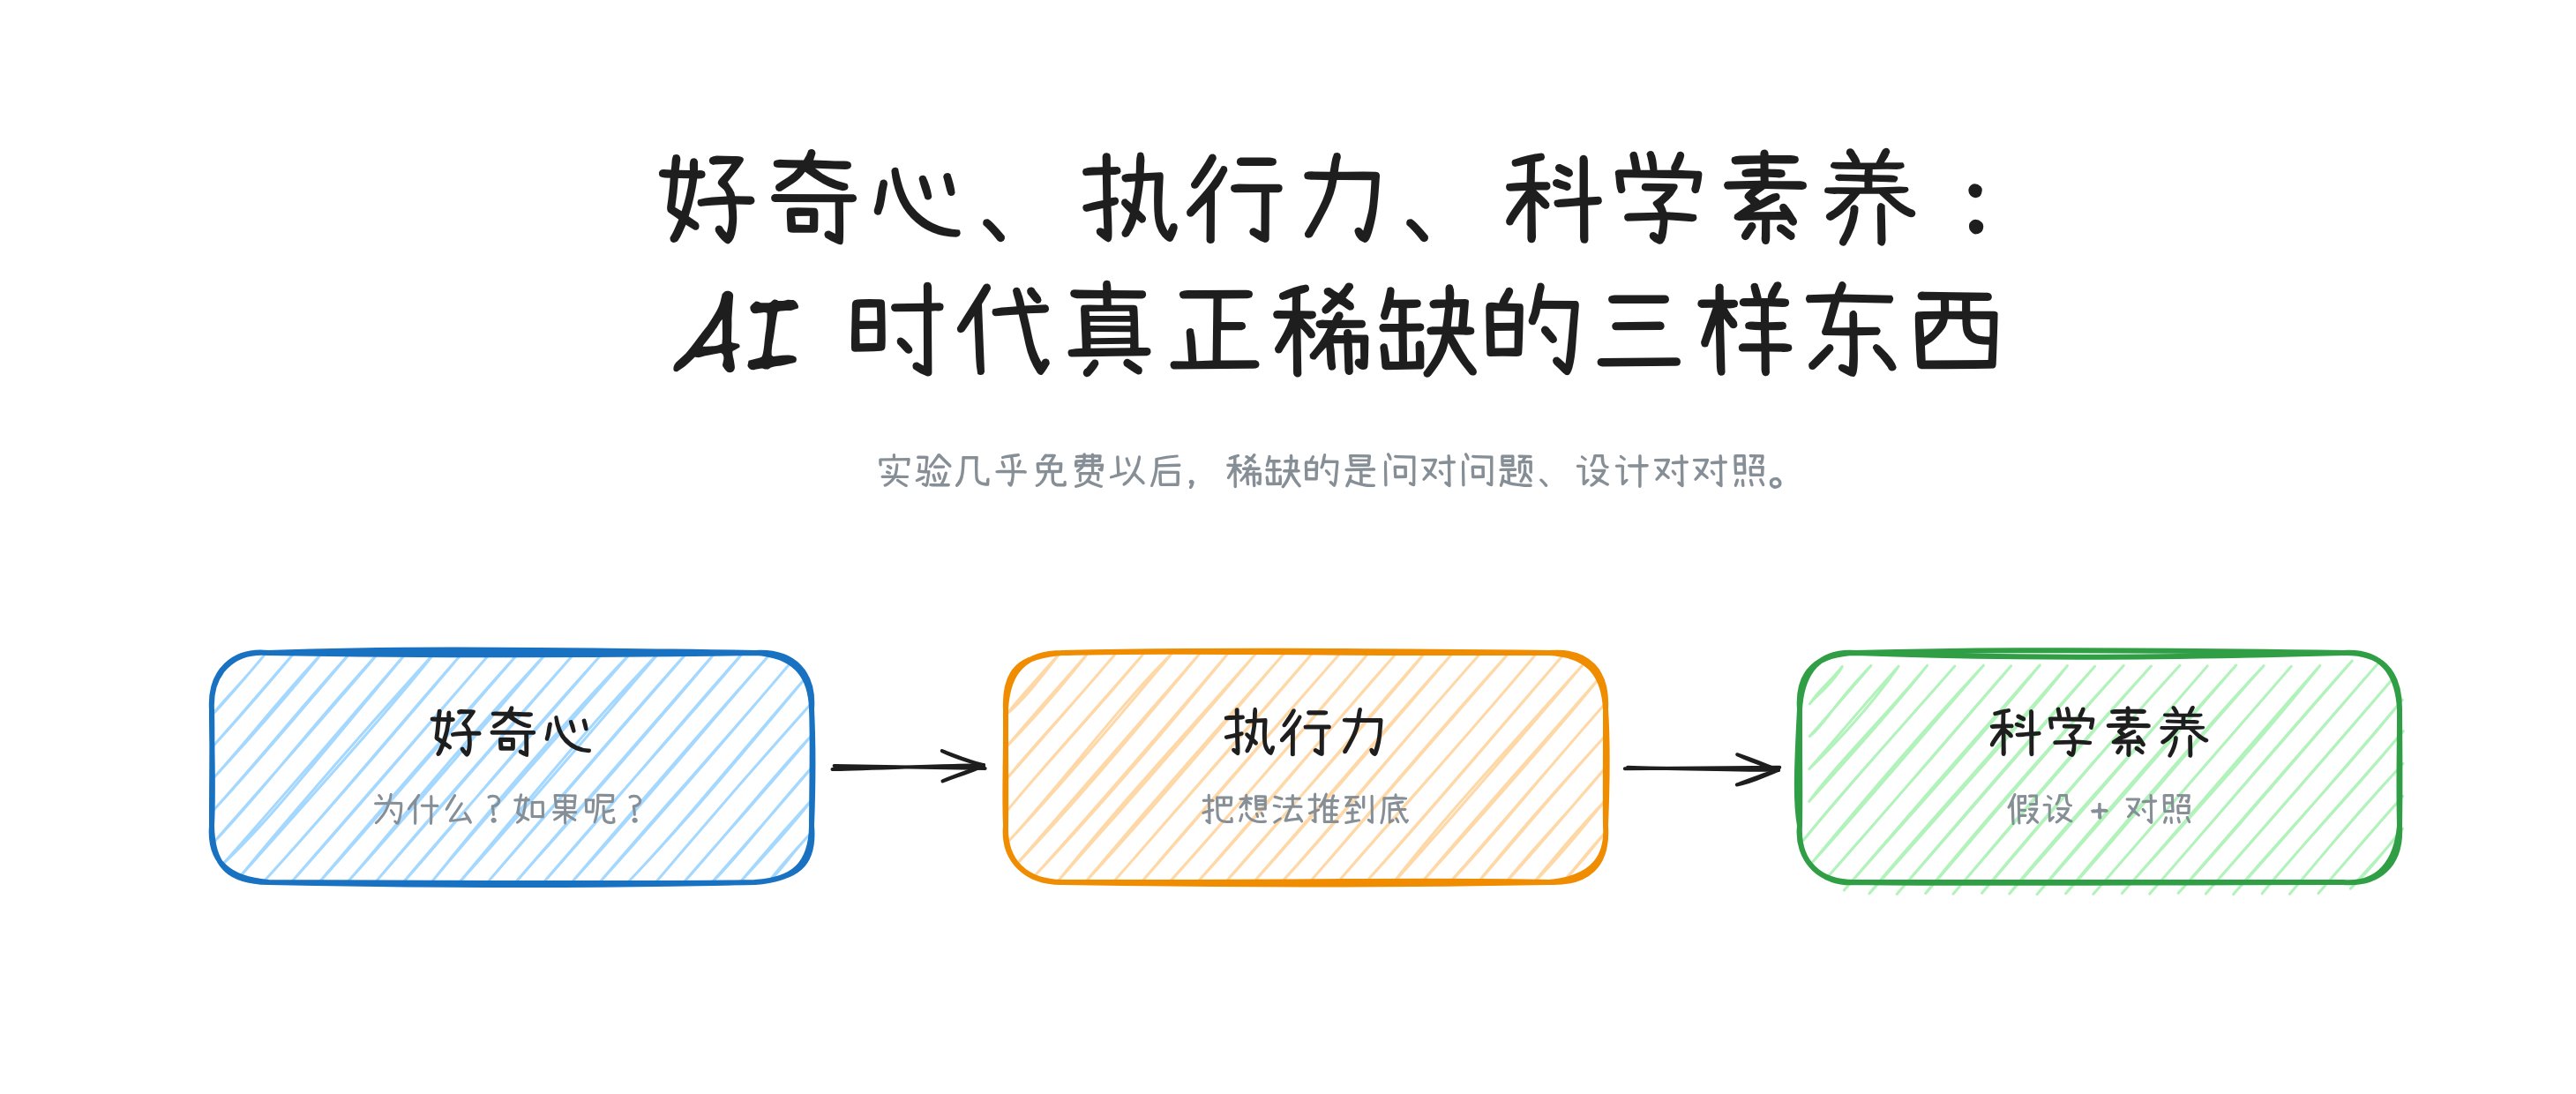
一、好奇心是发动机
所有探索都从“想知道”开始。为什么这样能行?它在哪里会坏?再往前推一步会发生什么? 这一点在 AI 行业格外重要,因为我们造的东西,恰恰也是我们还没搞懂的东西。我们训练的模型,自己解释不全;我们发布的 agent,每周都会做出意料之外的事。scale 为什么有效、推理能力从哪来、上限在哪,目前没人有完整的答案。 对工程师来说,这种处境很少见。大多数领域给你一套成熟的理论,让你去应用。AI 的理论还在写,而你在自己的终端里就能参与。 如果这件事让你兴奋不起来,后面的内容帮不了你。 好奇心也是让你不被自己的工具替代的唯一东西。agent 会回答你问的问题,但它不会自己去在乎哪个问题更重要。一直在问“为什么”“如果呢”的人,才是掌舵的人。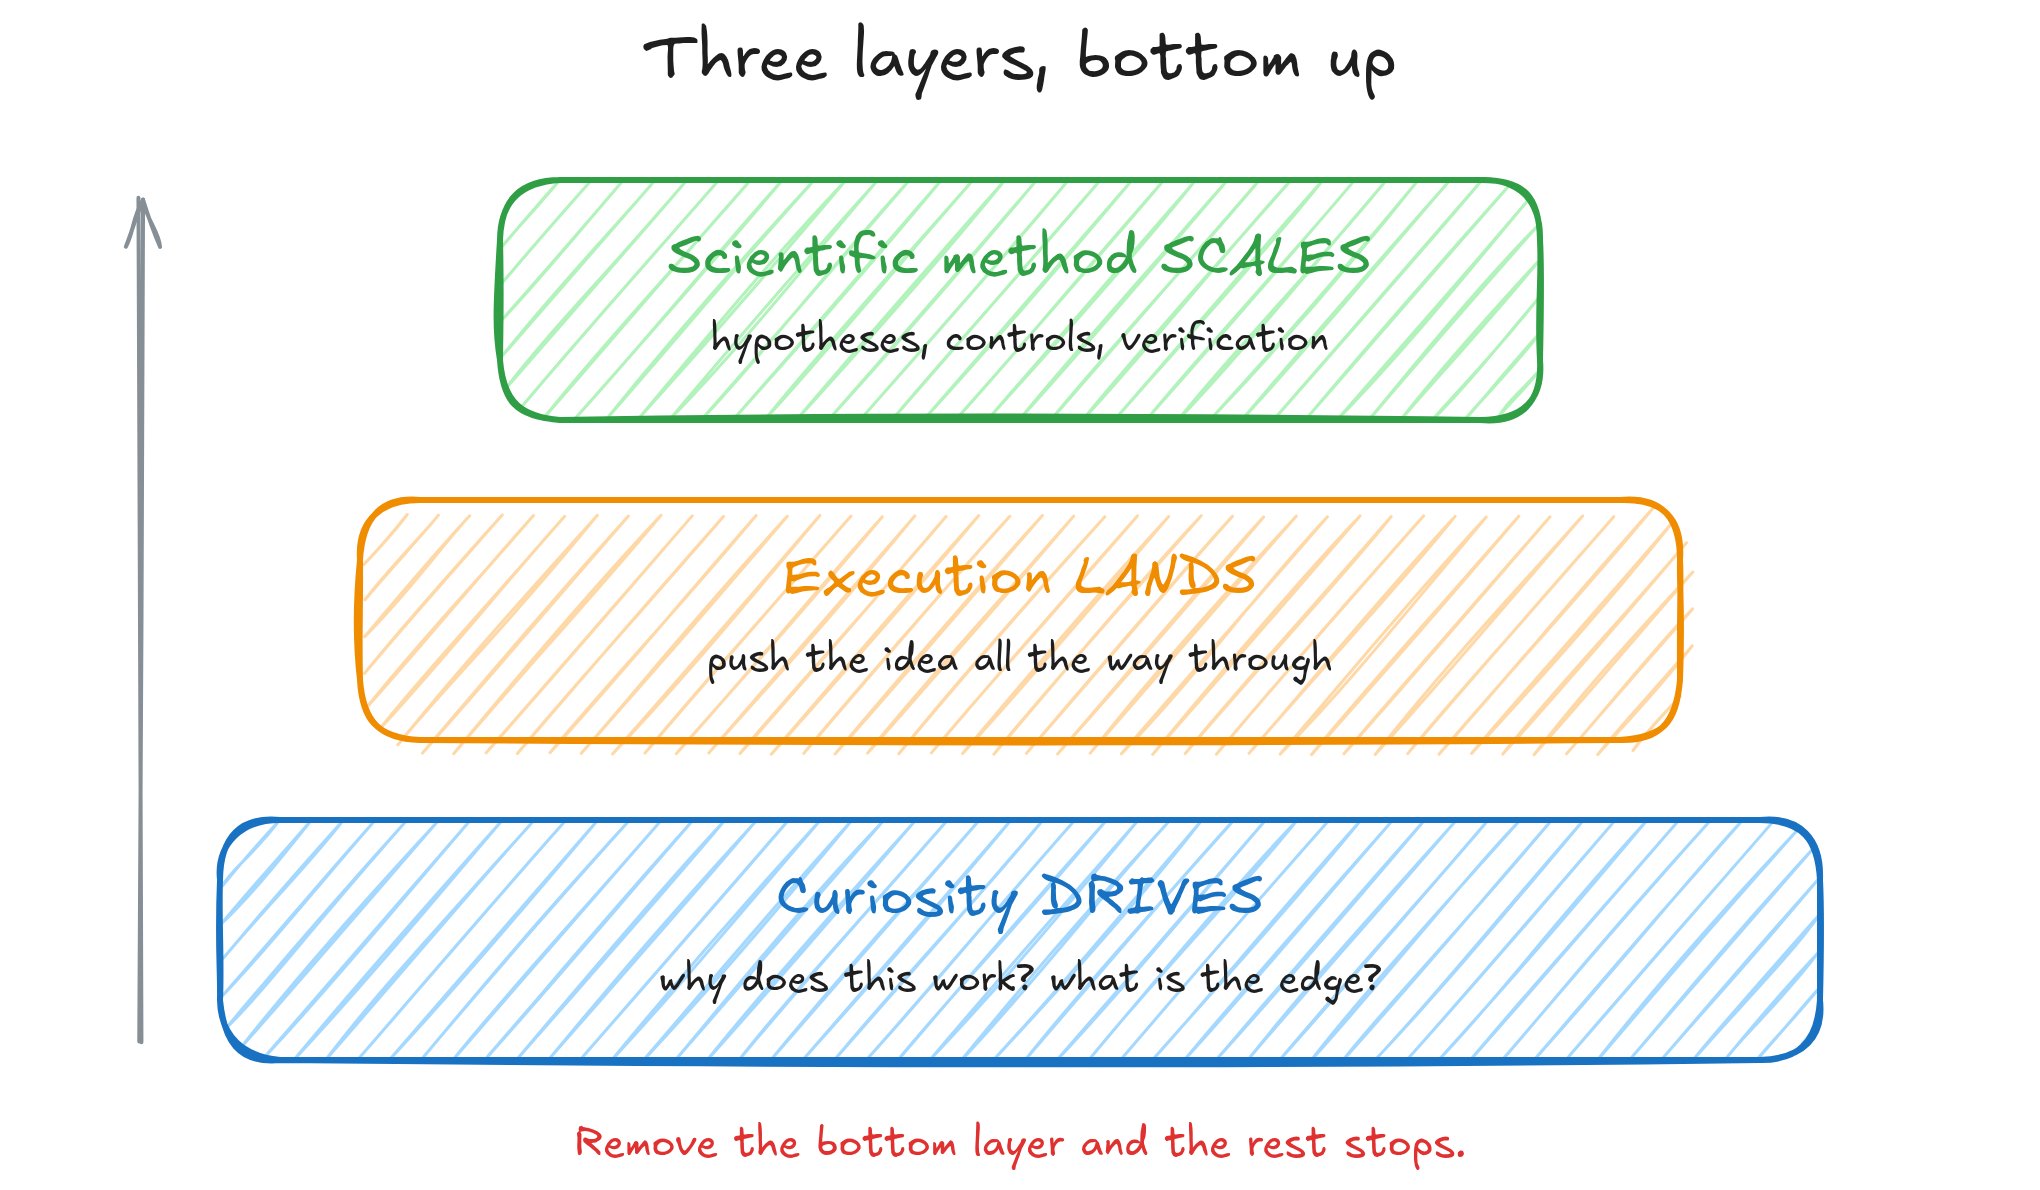
二、执行力:把想法推到底
只有好奇心、没有执行力,那叫爱好。 很多人以为 AI 解决了执行力。并没有。它去掉了摩擦,反而把真正的问题暴露出来:问题从来不是手速,而是做到一半就停的习惯。 有没有 agent,我看到的都是同一个模式。有人冒出一个想法,做出第一版,主流程跑通了,看着还行,然后就停了。边界情况“以后再说”,效果“显然更好”,总结“没必要写”。有了 agent,人更快走到这个半程,于是也更常停在半程。 借口也变得更体面了:“模型还不够强”“agent 理解错了”。有时候确实如此,但更多时候是我们没定义清楚什么叫做完,所以人和 agent 都不知道什么时候该停。 执行力,就是把想法推到底:要么真的跑通,要么因为一个清楚的原因失败。两种结果都可以接受。干净的失败能教会你东西;做到一半的“成功”什么也教不了你,因为你永远不知道它是不是真的。 落到做法上:- 开始之前写下“做完”的标准,而且要能检查。
- 要证据,不要汇报:一个通过的测试,一次真实运行,一个数字。
- 把无聊的部分做完。最后那 20% 往往才是真相所在。
三、科学素养是关键
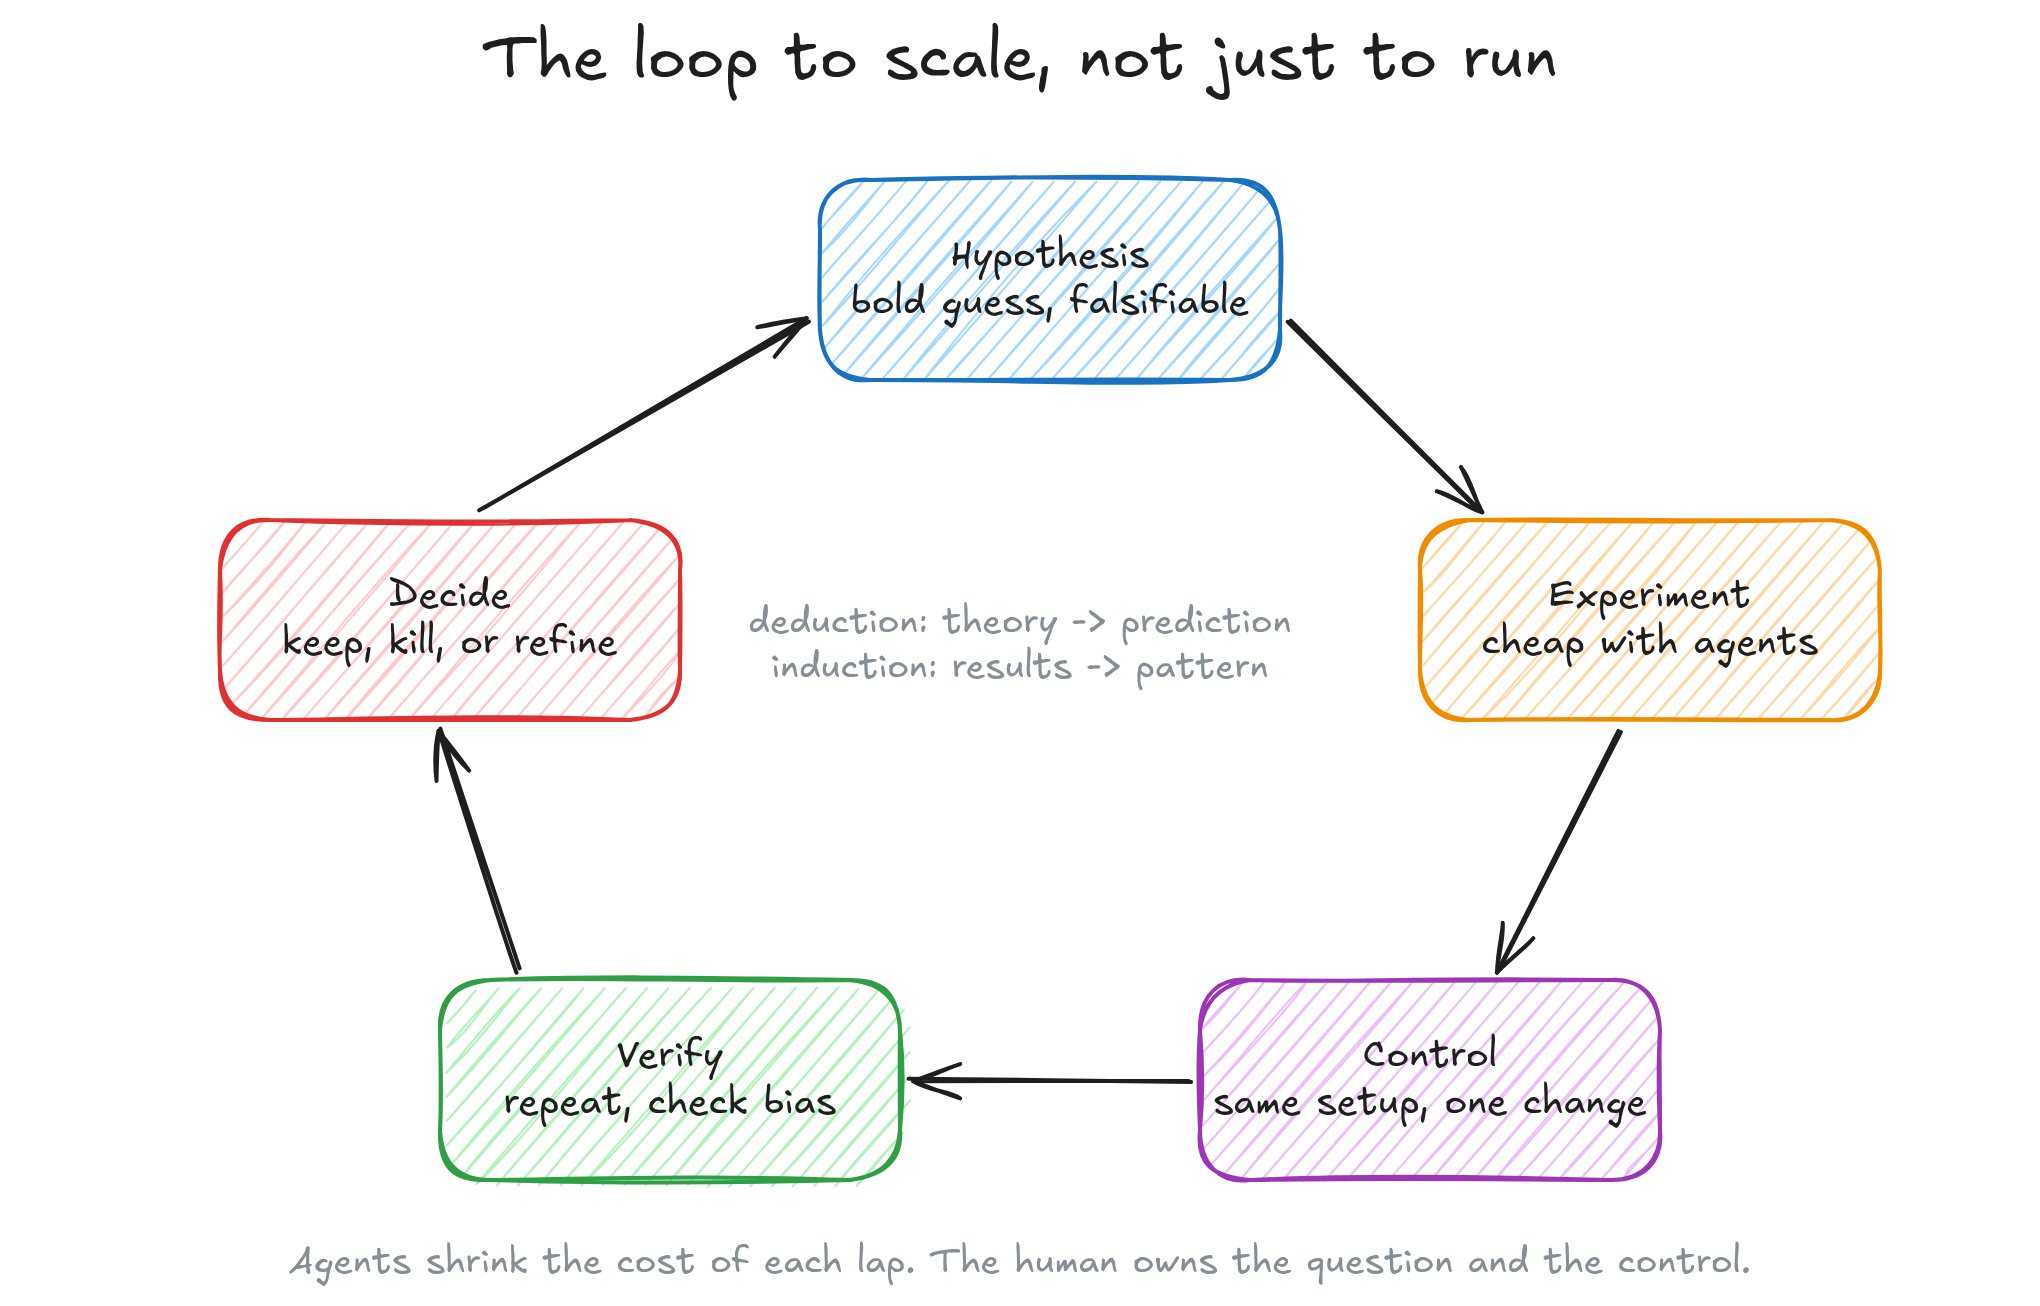
这一部分,我觉得大多数人都低估了。 一个实验要跑一周的时候,一个季度只能做几个,所以要挑得很仔细,因为错不起。现在 agent 一小时就能跑完一个实验,一晚上能并行跑一百个。单个实验的成本已经不是约束了。 约束变成了:你的实验到底有没有意义。 一百个没有对照的实验,就是一百个个例。一百个每次同时改三处的实验,对其中任何一处都说明不了什么。实验便宜以后,坏方法的危害反而更大,因为你现在可以批量制造误导性的证据。 所以问题从“这个实验怎么跑”变成了“怎么把实验规模化,又不骗自己”。这是科学方法的问题,老工具依然好用:- 提出假设。 具体到可以被证伪。“这个 prompt 改动能提升多步任务里的工具选择”是假设,“这个可能有用”不是。
- 大胆求证。 去试那个奇怪的变体,去试你觉得会失败的那个。实验已经很便宜了,就该这么用。
- 小心论证。 把测到的和相信的分开,说清楚你有多大把握、凭什么。
- 有意识地用演绎和归纳。 演绎:如果我的理论对,就应该出现某个具体现象,去验证它。归纳:在这五十次运行里,某个规律反复出现,先形成理论,再用演绎去检验。
- 设计对照。 同样的设置,只改一处。可以类比 A/B 测试,也可以类比双盲试验:评估者不该知道自己在看哪个版本,不管评估者是人还是模型。
四、一个例子:设计一个产品功能
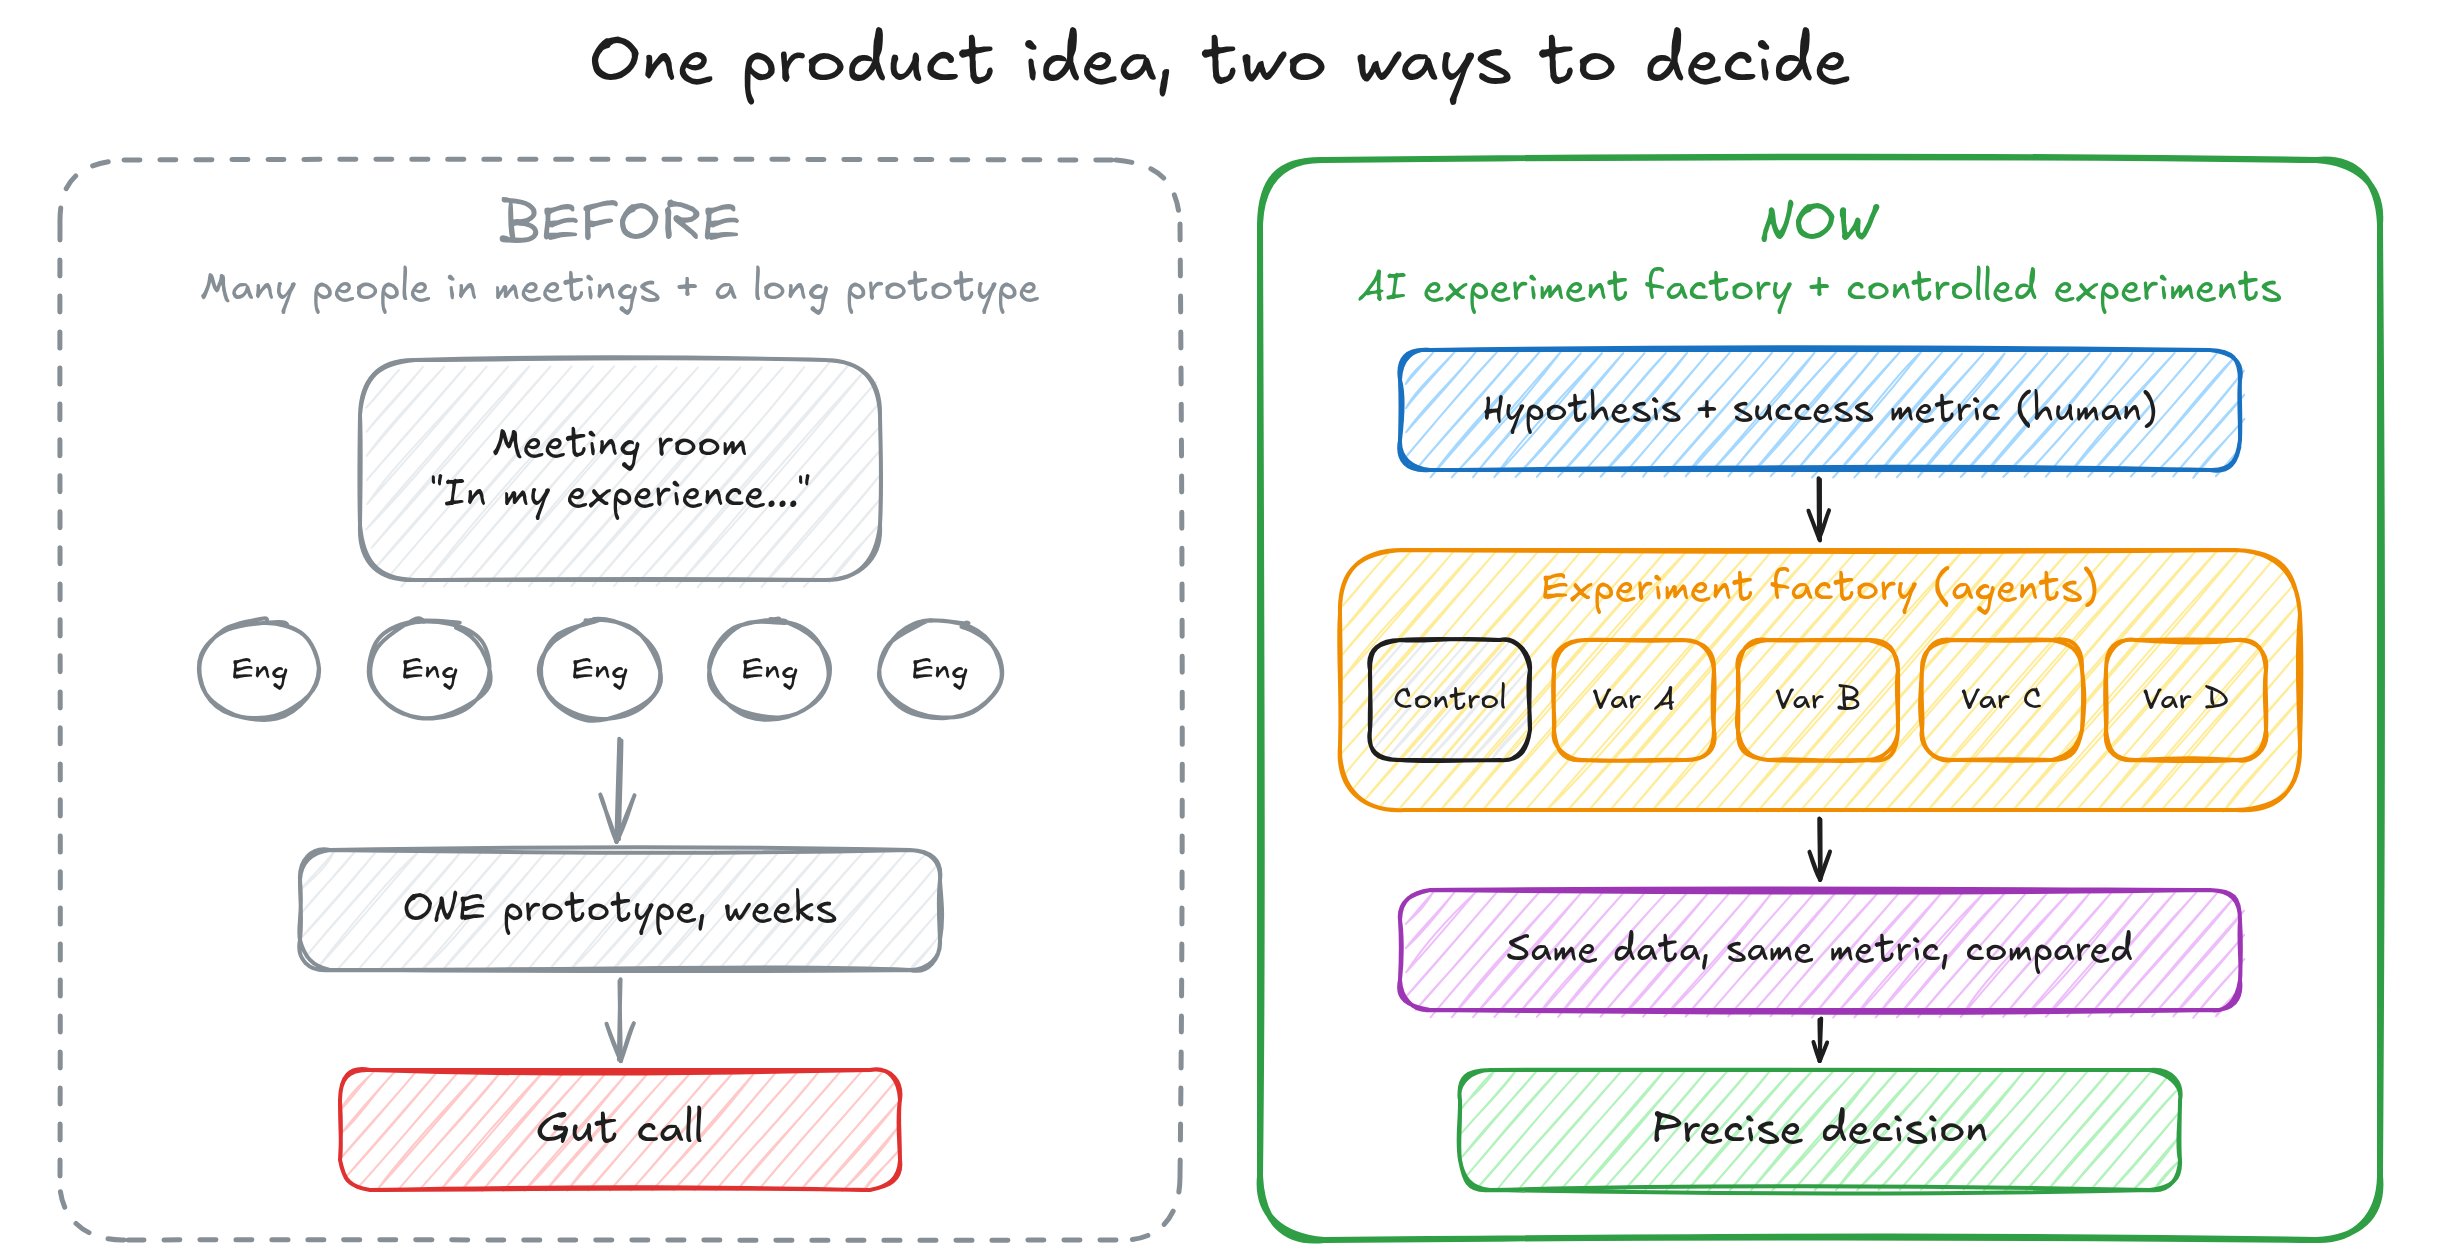
过去一个产品想法是怎么拍板的: 有人提出一个功能,约一个会,几个工程师、一个 PM,可能再加一个设计师。每个人都凭经验发言:“用户不会想要这个。”“我们以前试过类似的。”最后往往是声音最大或者资历最深的人说了算。然后一个小团队花几周,把胜出的那一版做成原型。等到上线,已经没人记得当初否掉了哪些方案、为什么否掉。 在做东西很贵的年代,这套流程说得通。现在说不通了。 更好的做法是:给 AI 一个实验环境,再给它一座工厂。 实验环境是一个沙箱,变体能在里面跑真实的输入:真实任务、录下来的会话、一套能测出你关心的指标的测试框架。工厂是生产变体的 agent 流程:把这个功能做出五个版本,再把现有行为当作对照组,全部用同一批输入去跑。 然后比较。同一批数据,同一个指标。指标难定义的地方,就用结构化的反馈:把输出去掉标签并排给评审看,收集他们的偏好。 人的作用没有变小,只是换了位置。假设是什么、成功怎么算、哪些变体值得试、对照组是什么,这些仍然要人来定。这些决定比写代码难,也正是你的判断力起作用的地方。 结果是,决策变得更精确。你不再是在几种意见里挑一个,而是在几个测出来的结果里挑一个。数据说不清的时候,你也知道它说不清,于是去设计下一个实验,而不是拍脑袋。