

- 为什么多数非 Coding 场景的 AI 使用,仍然难以深入真实的工作场景?
- 为什么优秀的工程师在 AI 时代越来越累,同时伴随一部分初级从业者面对工作时退化为「许愿机器」?
- 今天的 Agent 倾向于暴露执行过程,为什么这并不会让结果更加可控?
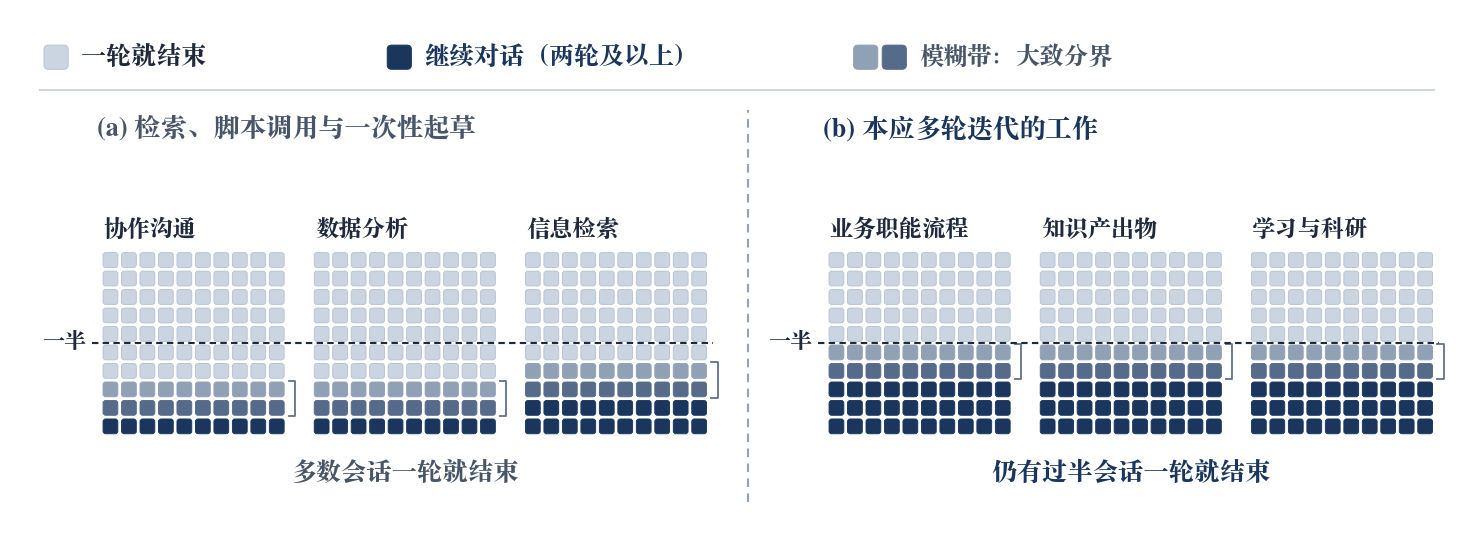
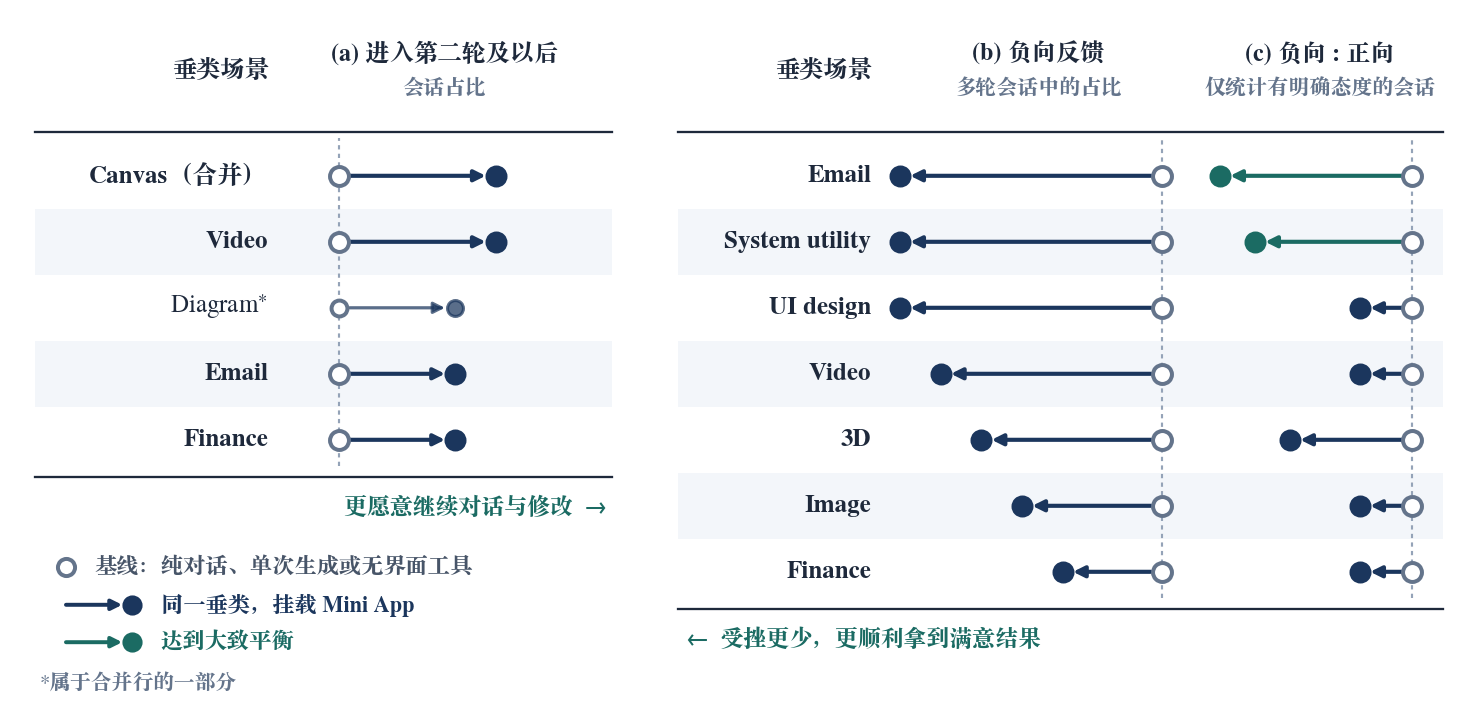
文中来自产品的数据只给出档位与方向,相应的图是示意图,不设刻度。
一、意图的形成
问题:为什么多数非 Coding 场景的 AI 使用,仍然难以深入真实的工作场景? 我们的回答:意图是在环境里形成的。 人并不是带着成型的意图来的,意图是对眼前事物的反应;空白的对话框几乎什么都没有放在人面前。让 Agent 进不了日常工作的,主要是这一点,而不是「不会写 Prompt」。1. 模型能力的过剩并没有自然转化为深入工作流的使用行为
今天主流 Coding Agent 所具备的能力,早已超出了普通白领日常工作的复杂度:它可以读写本地成百上千份文件、自己编写脚本清洗数据、核对账目与合同出入、串联外部接口,甚至现场搭建一个专用小工具。 但观察大多数人日常如何使用 Coding Agent 或各类 Chatbot,会看到明显的落差:高频发生的交互依然局限在少数几个刻板场景里,例如生成一份 PPT、起草一则通告、咨询某个法律或金融问题。在绝大多数时间里,AI 实际扮演的仍然是一个「高级搜索引擎」,很难真正深入日常工作流。这不是我们一家的现象:在目前规模最大的一项消费级 Chatbot 使用研究中,实用指导、信息查询与写作三类合计占了近 80% 的对话(Chatterji 等,2025)。 我们自己的使用数据呈现出同样的形状:办公类场景约占可分类使用的一半;在办公类任务内部,占比最大的两类依然是信息检索与生成单份知识产出物,两者合起来是明显多数,而实际深入到业务流程中的任务——数据分析、学习与科研、业务职能流程与协作沟通——加总起来只是少数。如果以人数来统计,这部分真正把 AI 深入使用到办公场景的人在人群中占比更少。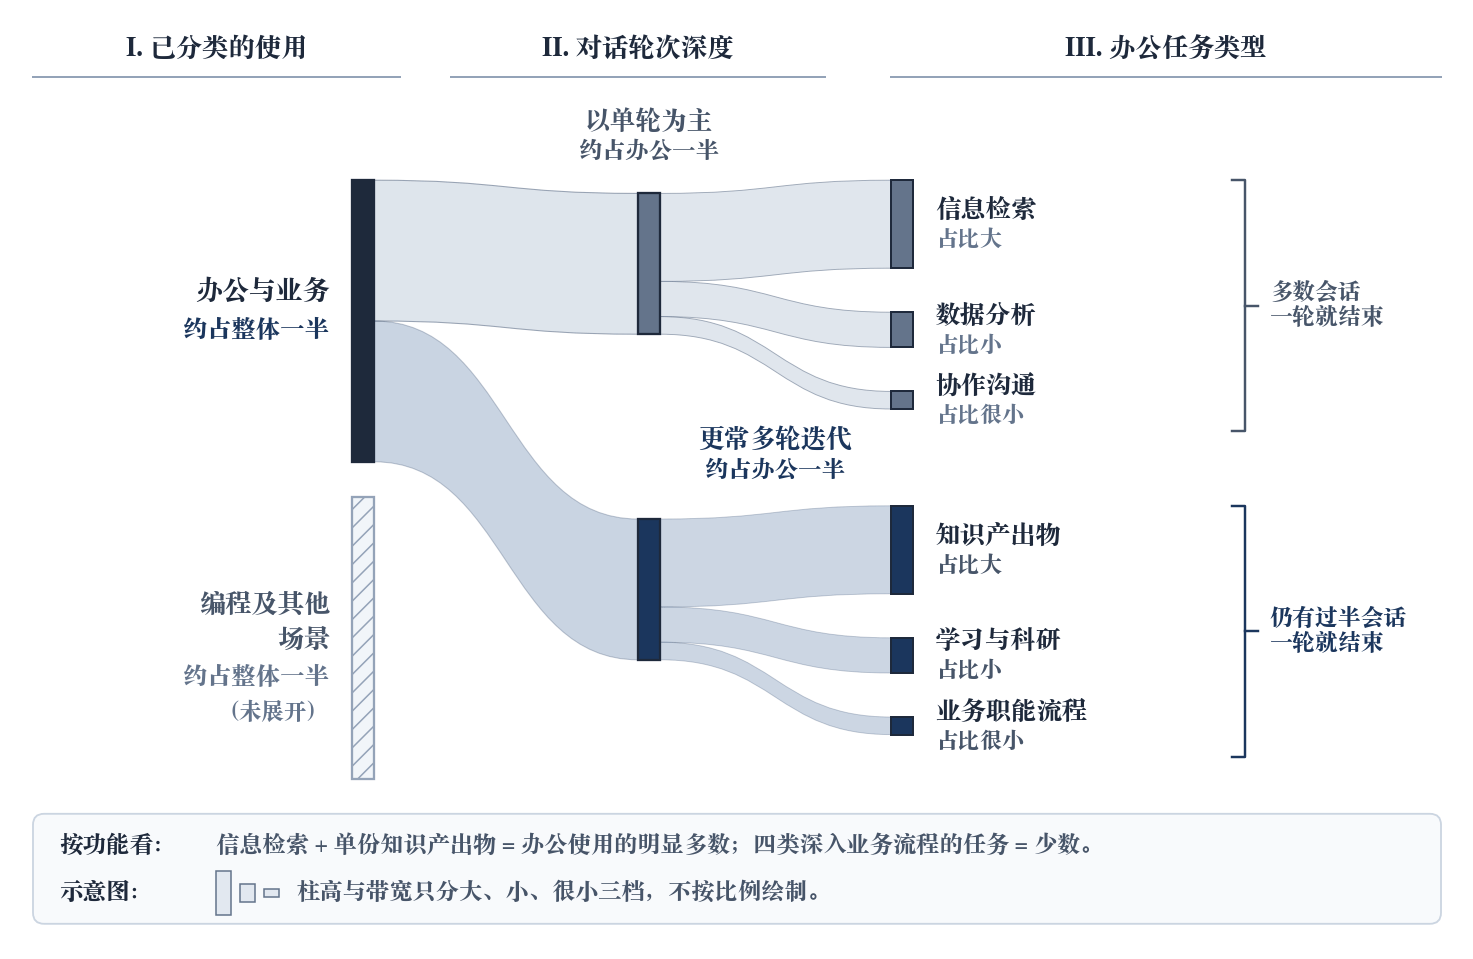
2. 人的思路受所处环境支配,正确的界面负责唤醒欲望与意图
过去人们常把这种现象归咎于用户「不会写 Prompt」,但问题其实出在更早一步:人在打开对话框的那一刻,根本没有产生让它干活的欲望。 传统工具设计默认人在打开软件前,脑子里就已经有了清晰的意图。但人是感情动物,思路在很大程度上受环境支配。成熟的软件产品早就深谙这一点:购物软件往往做得琳琅满目,旅行软件看起来总是舒适惬意。它们之所以如此设计,是因为正确的 UI 会勾起人的意图,而意图才会产生行为。电商早就区分过「搜」与「逛」:搜索框只能承接人脑子里已经想好的存量意图,而有氛围、有质感的界面环境才能诱发出增量意图。 生态心理学中的「可供性(Affordance,J.J. Gibson,1979)」与 Lucy Suchman(1987)的「情境行动(Situated Action)」理论解释了同一件事:人的计划很少是在大脑真空里预先想好再输出的,而是在看见具体对象、感受环境暗示的过程中长出来的。3. 单一的空白对话入口剥离了环境线索,导致 AI 难以深入工作流
反观今天的 Chatbot 与大多数 Agent 产品,无论底层挂载了多强的工具链,呈现在用户面前的永远是同一个空白输入框和闪烁的光标。 人机交互里有一条基础规律叫「识别优于回忆(Recognition over Recall)」:人擅长对眼前的具体状态做出反应,却极不擅长对着一片空白凭空召唤需求。Amelia Wattenberger(2023)对聊天界面的批评说的也是这件事:一个光秃秃的文本框,既不告诉人它能做什么,也不告诉人该怎么问。单一、抽离的对话入口抹平了一切领域纹理与现场感,无法对使用者产生深刻的环境影响。面对一句抽象的“有什么可以帮你”,大脑本能地退回到认知成本最低的旧习惯里——把它当成搜索引擎提问,或者只拿它处理那几件被反复宣传过的标准差事。换句话说,空白对话框只能收割存量意图,产生不了增量意图。 没有能够唤醒意图的环境,再强的执行能力也只能闲置在工作流之外。二、从委派任务到委派意图
问题:为什么优秀的工程师在 AI 时代越来越累,同时伴随一部分初级从业者退化为「许愿机器」? 我们的回答:委派意图不等于委派任务。 委派一件「任务」,步骤和验收标准是连同任务一起交出去的;委派一个「意图」,交出去的只是对结果的期望——声明 What,把 How 留给机器。横在两者之间的是 Why。Agent 不承担产生 Why 的那些现实后果,它只认人类写下来的产出契约。Agent 越快,这份契约越重要,学会写它也越难。1. 委派任务和委派意图之间存在现实鸿沟
1997 年,Ben Shneiderman 与 Pattie Maes 争论过软件交互的未来:前者主张可视、可控的直接操纵(Direct Manipulation),人自己对每一步操作负责;后者预言软件复杂度终将超过人类手动操作的上限,交互必然走向「异步委派(Delegation)」——人交代目标,Agent 在后台代人行事。 三十年后,从 Cursor 到 Claude Code、Codex,编程工具的演进完整复现了 Maes 当年的判断。Jakob Nielsen 在 2023 年将这种变化概括为六十年来的第一次 UI 范式转移:从「基于命令(指定 How)」跃迁到「基于意图的结果声明(指定 What)」。用我们的话说:过去我们委派的是任务,现在我们被邀请去委派意图。 但如果「声明 What、由机器完成 How」就是全部真相,推论应当非常直接:程序员乃至所有工程师的失业只是时间问题。 现实给出的数据却没有这么简单。斯坦福数字经济实验室(Brynjolfsson 等,2025)追踪全美数百万人的薪资记录发现,到 2025 年 7 月,22–25 岁软件开发者的就业较 2022 年底的峰值下滑了近 20%,而同一职业里更年长群体的就业仍在增长。这项分析是描述性的,不是因果结论,但它和我们身边看到的情况吻合:初级岗位承担的标准实现正在被快速替代,对有经验的判断力的需求却没有减少。 这说明在 How 与 What 之间,依然横亘着一道没有被模型填平的 Gap。2. 软件的稳健依然依赖人类定义系统框架与测试契约
观察今天优秀的软件工程师如何工作,就能看清这道 Gap 的轮廓。 我们身边的很多人,确实已经把几乎全部的具体代码交给黑盒智能体完成,但始终把两件事留在自己手里:定义问题与系统框架,以及制定 Test 和 CI 规则。 这解释了当下软件工程里一个看似矛盾的现象:软件迭代越来越快、功能越来越臃肿,整体运行却依然稳健。挡住混乱的并不是模型不再犯错,而是人类在黑盒外部立下的测试、门禁与边界。行业报告指向同一个方向,但要带着限定来读:2024 年的 DORA 报告在其调研样本中估计,AI 采用率每提高 25%,交付稳定性相应下降约 7.2%,报告作者把原因指向小批量、充分测试这类工程基本功;GitClear 对代码变更的分析则报告,写完不久就被回滚或重写的代码比例在上升。 CHI 2024 上,Subramonyam 等人把这种认知挑战定义为「设想鸿沟(Gulf of Envisioning)」:面对非确定性的生成式系统,仅声明模糊的目标远远不够,人仍然要想清楚任务到底是什么、该怎么交代给模型、又该如何判断产出是否达标。3. 持续监控意图偏差与契约有效性加剧了人的认知负担
和几位重度使用 Agent 的优秀工程师交流后,一个普遍的反馈是:工作并没有因为 AI 而变轻松,反而更累了。 过去手写代码时,设计思考随着实现过程同步展开,节奏是平缓的;如今代码生成近乎瞬间完成,工程师节省了敲键盘的操作成本,却要把全部精力投入到高强度的审视中:持续监控自己的意图是否表达清楚、实际执行与预期偏离了多少、既有的测试契约是否依然有效。这笔成本甚至大到付账的人自己都察觉不到:METR 在 2025 年做过一项随机对照试验,让有经验的开源开发者在自己熟悉的仓库里干活,结果允许使用 AI 工具时任务耗时反而更长,而开发者自己却认为变快了。 这种疲惫在研究中已有清晰的对应:- 元认知负载上升(Tankelevitch 等,CHI 2024):操作负载下降的同时,自我监控、拆解委派与持续核验的元认知负担在上升;《哈佛商业评论》2026 年的一项研究把监督 AI 带来的认知疲劳称为“Brain Fry”。
- 自动化的反讽(Lisanne Bainbridge,1983):自动化率先接管了常规、顺手的工作,留给人类的全是设计者没能自动化的部分;人因为脱离一线实现而手感生疏,却要在系统越界时承担兜底责任。Simkute 等人(2024)把这组反讽原样搬到了生成式 AI 上:人的角色从「生产」变成「评估」,自动化让容易的事更容易、难的事更难。
4. What 与 How 之间的鸿沟在于 Why,并且正在持续加深
回到最初的问题:横亘在 How 与 What 之间的那个 Gap,究竟是什么? 答案是 Why。 同一个 What,可以有一百种跑得通的 How。Agent 为什么必须这样做、为什么绝对不能那样做,背后是业务代价、历史包袱与系统权衡。Agent 可以把一个权衡讲得头头是道,但它不承担现实后果,无法自己生长出 Why,也就不该由它来拍板;它唯一可靠遵循的准则,是人类将 Why 转化并固化下来的产出契约。 不幸的是,随着 Agent 能力增强,这道关于 Why 的鸿沟不仅没有缩小,反而在加深:- Agent 跑得越快,漏写契约的代价越大:生成 How 的速度越快,任何一个未被写进契约的隐性假设,都会更快地演变成跨模块的既成事实与技术债。
- 不写 How 之后,人更难学会 Why:过去工程师恰恰是在亲手编写 How、反复踩坑的过程中,逐步建立起对系统 Why 的理解。这一点现在已经在编程上被测量到了:Shen 与 Tamkin(2026)的随机实验显示,借助 AI 学习一个新库的开发者,在概念理解、读代码和调试上都更弱,完全委派的人学到的最少。当 How 被彻底封装进黑盒,行业对「定义契约」的要求达到了顶点,而培养这种判断力的日常土壤却在流失。
三、人与 AI 之间的交互是否需要完全透明
问题:今天的 Agent 倾向于暴露执行过程,为什么这并不会让结果更加可控? 我们的回答:折叠可逆过程,呈现模型的假设。 把过程给人看,不等于把控制权交给人。可逆的步骤应当退到视线之外;必须摆到人面前的,是模型做出的假设,并且摆在界面设计者预先定好的关键节点上——而不是指望模型自己察觉。1. Agent 的高速执行已经让原始过程的实时透明在物理上失效
早期大模型以对话形态出现时,流式输出的速度与人类的阅读速度大致匹配,看着文字逐行浮现是一种自然的交互体验。但现代 Agent 系统的执行效率已经彻底打破了这个平衡。 如今主流 LLM API 的输出速度常常达到 100–200 Tokens/s,且仍在持续提升;配合本地终端与工具链,一个 Agent 常常在一分钟内就能连续执行数十次 CLI 命令、文件读写或检索调用。而成年人默读英文非虚构文本的平均速度约为每分钟 238 个词(Brysbaert,2019),按我们自己的折算大约是每秒五六个 Token。两者之间存在着数十倍的带宽落差。 当界面依然试图把所有的推理过程、命令行参数和返回日志原封不动地滚在屏幕上时,「透明」就已经变味了。传播学者 Mike Ananny 与 Kate Crawford 在批判算法透明度迷思时提出过一个概念,叫「看见却并未理解(Seeing without Knowing)」:把系统内部的海量原始状态直接摊在用户面前,并不等于赋予了用户理解力与控制权;相反,它往往把解析复杂信息的认知负担转嫁给了人类,用「我已经全部展示给你了」的形式免责,掩盖了交互设计上的懒惰。2. 过度暴露中间细节会诱发审批疲劳并削弱人对关键错误的判断
在直觉里,即便人看不过来全部日志,尽可能多地展示中间细节、并在敏感步骤弹窗请求确认,总归比黑盒更稳妥。但实证研究给出了相反的结论。 微软研究院的 Poursabzi-Sangdeh 等人在 CHI 2021 发表过一组预注册的随机实验,规模达 3,800 人,专门检验模型透明度对人类决策的影响。结果显示,面对内部清晰透明的模型时,受试者发现并纠正模型重大错误的能力,反而低于面对黑盒模型的受试者——作者认为原因很可能是信息过载。后续研究也表明,光给解释并不能治好盲目信任,在决策点上逼人停下来想一想的界面效果更好(Buçinca 等,2021)。 这种机制在日常使用 Agent 时表现为典型的「审批疲劳(Approval Fatigue)」。当一个任务在一分钟内触发十几次工具确认弹窗时,人的注意力会在最初几次审阅后迅速枯竭,随后的操作退化为肌肉记忆式的连续点击允许,或者干脆切入全放行模式。同行也在报告同样的事:Anthropic 在解释 Claude Code 为什么转向沙箱时,给出的理由之一正是审批疲劳。纸面上的「人在回路(Human-in-the-loop)」,在高频噪声的冲刷下很快就会演变成走过场。3. 可逆的安全围栏只兜住了操作底线,并未在人机交互上完成突破
人们很早就意识到让 Agent 自由执行命令存在风险,因此工程界率先建立了一套严密的安全围栏。例如在我们的 MiniMax Code 中,系统会强制使用trash 命令替代危险的 rm 命令,同时在后台静默运行一套版本管理系统,确保 Agent 执行的每一步本地改动都是随时可回退的。
这类设计非常必要,但它解决的是安全兜底问题,而不是人机交互问题。
回退机制保证了「即便做错了也不会造成无法挽回的破坏」,却没有回答「人究竟该如何低成本地理解、引导并验收一个高速运转的智能体」。如果 Agent 在十分钟里改了几十个文件、试错了好几条路径,人固然可以一键回滚到起点,但要想弄清楚「它现在走到了哪里、为什么要改这几个模块、结果是否可信」,依然要在要么盲信结果、要么翻阅几千行执行日志之间二选一。安全上的可逆,并不能自动转化为认知上的可控。
4. 理想的交互应当折叠可逆过程,并由 UI 在关键节点上呈现模型的假设
计算机科学处理底层复杂度的历史,从来不是靠「更透明」,而是靠「提高抽象层级」。今天没有人会要求编译器把生成每一条汇编指令的过程实时滚在屏幕上——当底层机制足够可靠或可逆时,向用户暴露低维细节不叫透明,而叫抽象泄漏。 恰恰因为有了trash 与静默版本控制这样的可逆围栏,工作区内的大量中间检索、读取和局部试错,已经变成了零风险的内部实现(How)。在推进这些实现时,模型可以做假设,我们也无需指望模型自己去察觉假设的偏差;真正有效的做法,是通过 UI 设计预先定义好工作流中的关键节点,让模型所做的假设在这些节点上直接转化为可视的对象呈现出来。我们自己的经验法则是:凡是几种可行结果的差别正是人在意的地方、后续工作要建立在这个选择之上的地方,或者影响即将跨出沙箱的地方,就是关键节点。
HCI 领域早年的两项经典思想,恰好描述了这种机制,我们在此基础上各往前走了一步:
- 平静技术(Calm Technology,Mark Weiser & John Seely Brown,1996):好的系统应当能在人类注意力的「边缘」与「中心」之间平滑切换。按我们的理解,Agent 在可逆沙箱内的常规推演应当退居人的余光背景;只有到达预设的关键节点,或即将触碰跨出本地沙箱的不可逆边界(如推送远端、调用外部写接口)时,才进入人类的注意力中心。
- 有缝设计(Seamful Design,Matthew Chalmers,2003):既不追求刷屏式的原始全透明,也不做成毫无抓手的黑盒,而是有意把系统的「接缝(Seams)」露出来让人使用。我们把这些接缝落在那些决定结果走向的关键节点上。
四、我们的立场:面向意图引导、意图编辑与意图执行的 AI 应用设计
三个回答指向同一个设计。 AI 原生的应用应当给人一个介于专业软件的白盒与聊天框的黑盒之间的中间态:一个能唤醒意图的工作现场,加上少数几个编辑意图的抓手;同时给 Agent 相反的东西:一个确定性的底座,开放软件全部的原子级操作。这是同一个设计的两面。1. 面向人类的界面应当在纯白盒与纯黑盒之间只保留最基础的意图编辑工具
前面提到的这些问题,或多或少已经被不少 Agent 产品意识到,由此诞生了越来越多的 Agent UI 接口,例如 MiniMax Mini App(轻应用)、Claude Artifacts、Antigravity UI Extension:在对话旁边放一块人和 Agent 都能操作的活的界面。 在我们的实践中,我们不仅推出了 Mini App 这样的基础设施,还自主设计了 3D Design 这款产品:UI 负责提供 3D 预览,以及打印前检查所必需的诊断视图;Agent 则在后台负责编写建模脚本、完成几何构建,并把结果直接推入右侧 UI 面板。当用户想修改局部细节时,直接在模型表面选点、描述,Agent 把这句话落到参数上,重建几何并重跑打印前检查,再刷新回面板。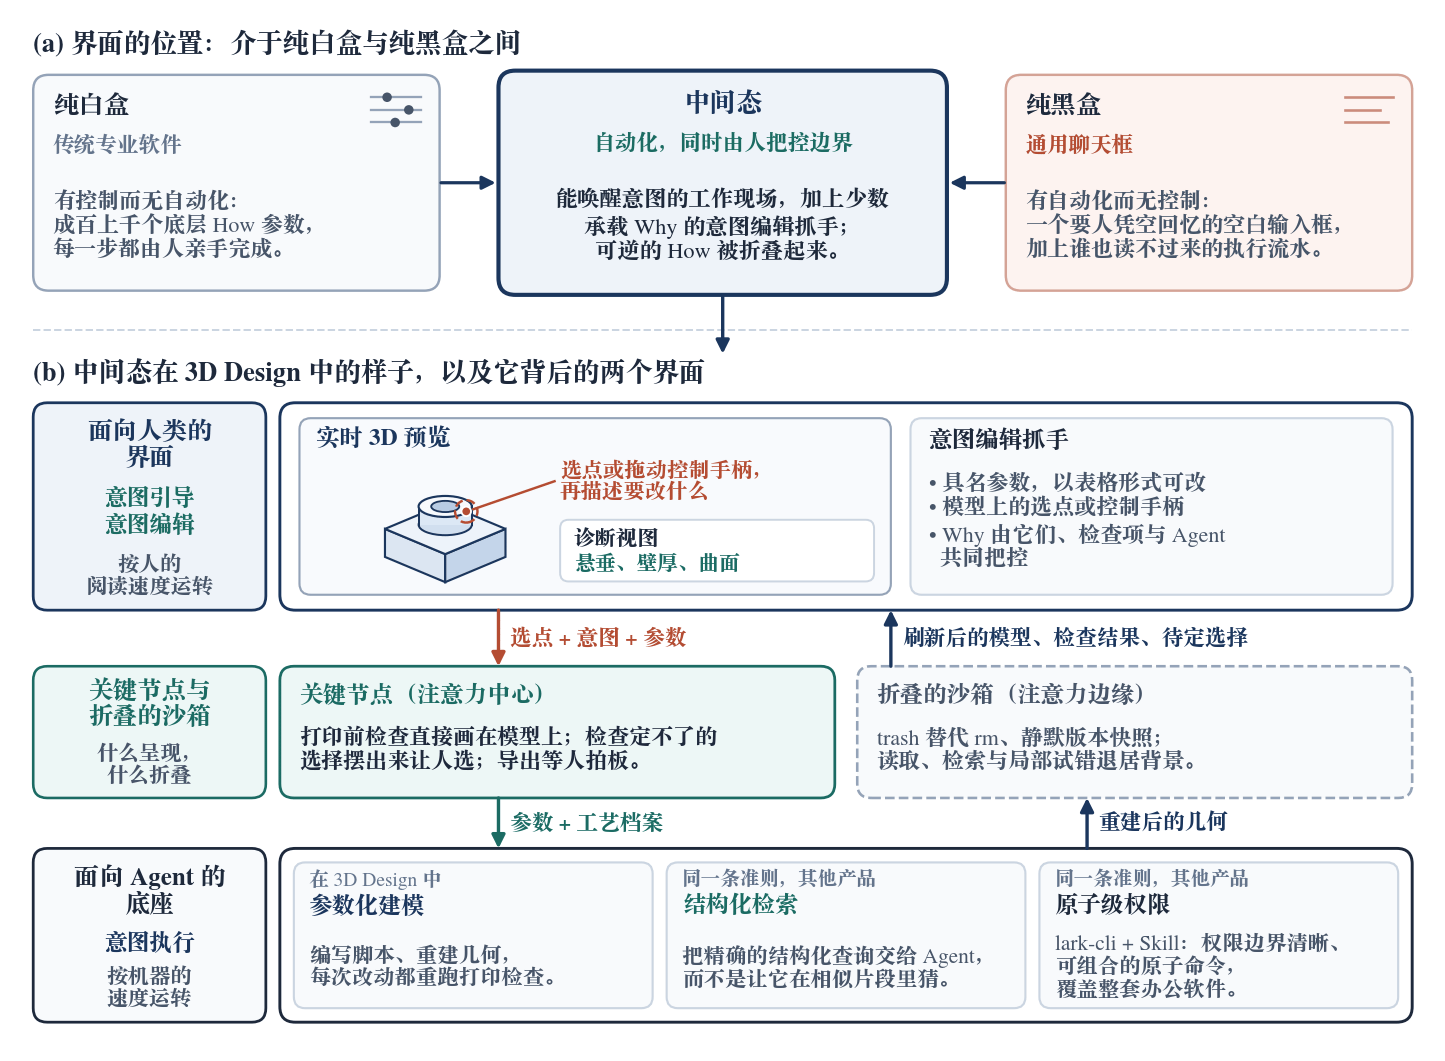
2. 没有图层和轨道的地方,假设如何变成可编辑的契约
3D 打印是个友好的场景:物理规律是固定的,检查清单是有限的。在 3D Design 里,Why 不是靠往输入框里敲一句话来承载的,而是由界面上的关键节点、交互工具和 Agent 共同把控——留在人面前的只有四样东西:声明过的框架(具名参数与工艺档案)、交付前直接画在模型上的检查、检查定不了而摆出来让人选的选择,以及用来指向的抓手。代码重构、财务尽调这类任务,既没有图层,也没有时间轴;但这四样东西没有一样依赖于几何,所以同样的做法也说明了运行时的隐含假设该如何被提取出来、变成可以编辑的东西。 分量最重的是第三样,它给出了一个可操作的定义:值得呈现的假设,就是在若干个都能通过检查的方案之间做出的选择。 检查能定的,是 How,留在折叠里;检查定不了的,是尚未敲定的 Why。Agent 被要求在做出每一个这样的选择时就把它记下来——选了什么、放弃了什么、作用在哪里——界面再把这条记录挂到它影响的位置上,让人可以一键改掉。
我们并不认为这件事在垂直场景之外已经解决。那里的检查清单不是封闭的,Agent 完全可能做出一个没有任何检查看得见的选择。我们目前的做法分两半:把每一次反复出现的意外,都当作一个该补上的检查;让 Agent 在做选择的当下就把它声明出来,而不是指望事后去发现。
更早的那两个例子遵循的是同一个模式:照片编辑里图层是抓手,视频剪辑里轨道是抓手;色阶曲线和转场之所以可以折叠,是因为有检查或廉价的撤销兜着。有人会担心,折叠这些细粒度的控件,会不会抹杀创作者的审美与「手感」?其实不会。局部参数的调校手感本质上仍是执行技艺,模型会在这件事上越做越好。人最宝贵的注意力在于整体性的维护——比如大多数时候和谐更美,而在有的画作中,「冲突」才是需要被表达的核心。用户表达审美,只需要知道表达意图的入口在哪里、在哪个位置把这种冲突指出来即可。
3. 我们的产品信号指向同一个方向
我们把从 Mini App 开始的会话,与同一垂类里最接近的基线——纯对话、单次生成工具,或没有界面的工具——做了对比。三个信号都指向这一立场所预期的方向:- 继续。 在我们对比过的每一个垂类里,挂载 Mini App 的会话都更有可能进入第二轮。我们把它读作环境在做第一章要它做的事:一块有可见对象的面板,会激发人继续探索、把工作往深处做的欲望。这就是在会话开始之后才长出来的增量意图。
- 受挫。 在确实继续下去的会话里,出现明确负向反馈的比例,在全部七个垂类里都是挂载 Mini App 时更低;不同垂类下降的幅度差别不小。
- 平衡。 在纯对话里,开口表态的人多半是在抱怨。挂载 Mini App 之后,负向与正向的比例在全部七个垂类里都向均衡靠拢,其中两个达到了大致平衡。
4. 面向 Agent 的底座必须摒弃模糊封装并开放软件全部的原子级业务权限
当界面对人类收敛为极少数契约抓手之后,软件底层对 Agent 又该如何设计,才能让上游定下的意图与契约可靠落地? 在过去的实践中,我认为 Agent 时代最差的检索方式,就是把向量相似度的片段检索(RAG)当作 Agent 进入业务文档的唯一入口——它将「业务理解」与「执行逻辑」混为一谈。当用户想要检索某些内容信息时,它无法精确控制内容的归属、标签、关键词、情感倾向等维度,只能让 Agent 在大量模糊片段中猜测业务走向;而当这种猜测继续转化为下一轮检索需求时,Agent 又不得不重新进行一轮无厘头的猜测,最终让完成任务彻底变成了概率游戏。直到后来,在那个业务中我们把精确的结构化查询与过滤能力交给 Agent(我们用的是 Elasticsearch),任务才得到了完整的解决。相似度检索在开放式召回上仍有它的位置;我们想说的是,谓词应该握在谁手里。 这个案例说明,Agent 作为意图委派的执行者,它真正负责的是将业务理解转化为执行逻辑;而承接这一转化的执行环境至关重要。模型推理本身带有概率性,它脚下的工具与权限底座就必须足够确定、透明且粒度够细——Agent 需要拿到软件全部的原子级业务权限。 在这方面,lark-cli 及其配套的 Skill 体系是我们见过最好的例子。它没有把办公软件封装成一个能力受限的聊天窗口,而是把文档、表格、多维表格、日历、审批乃至底层原生 OpenAPI 全部拆解为权限边界清晰、结构化可组合的原子命令,再通过 Skill 引导 Agent 编排调用。这些命令本身还编码了可逆性:邮件类命令默认只存草稿,加上显式的确认参数才会真正发出——真正浮出水面的,正是那个不可逆的步骤。至于 Skill,它沉淀的是可复用的 How,承载不了 Why——这也是为什么借来同事的 Agent,并不能让实习生的产出变得可用。
对人类收敛界面按钮,对 Agent 开放全部原子级业务权限,构成了现代 AI 软件的一体两面。
5. 未来的 AI 应用设计应当面向意图引导、意图编辑与意图执行三个重点
把全文关于人与 Agent 关系的讨论收束起来,面向未来,我认为 AI App 的设计应当面向三个重点:- 意图引导:告别单一冰冷的空白输入框,用有领域语境、有情绪质感的工作现场与可见对象勾起人的欲望,让增量意图在具体环境里自然产生,而不是坐等存量意图上门。
- 意图编辑:在纯白盒与纯黑盒之间建立中间态,折叠可逆的中间过程,只把四样东西留在人面前:声明过的框架、画在产出物上的检查、检查定不了的选择,以及空间选点、图层、轨道这类用来指向的抓手,让人低成本地划定与修正契约。
- 意图执行:构建确定性的底层执行环境,拒绝把业务理解与执行逻辑混为一谈的模糊黑盒,把精确的查询能力交给 Agent,像
lark-cli及其 Skill 开放完整业务原语那样,赋予 Agent 软件全部的原子级业务权限,让它把人的意图可靠地转化为最终结果。
五、我们认真对待的几种反对意见
「模型再强一点,对话框就够用了。」 有了记忆、主动性和更好的意图推断,Agent 也许能自己补上空白对话框缺失的语境。这是我们盯得最紧的一条反对意见。我们的回答是:模型只能从双方都看得见的东西里去猜人可能想要什么,而一条在恰当时机出现的建议,本身就是一条环境线索——这正是第一章的回答。如果有产品只换模型、保留光秃秃的对话框,非 Coding 场景的使用深度依然上去了,我们会改变看法。 「折叠就是不透明。」 对审计来说,执行轨迹就是记录;对学习者来说,它就是教材。我们同意,折叠也不等于删除:轨迹随时可以按需展开,不可逆的步骤永远会浮出来。我们反对的,是把原始轨迹当作默认的交互界面。 「预先定下的关键节点不具备扩展性。」 这是我们论证里最大的缺口,第四章第 2 节是我们目前的回答:声明的框架、交付前的检查,加上一条「该呈现什么」的规则。执行前先审一遍计划——像 Magentic-UI 的协同规划和各家 Coding Agent 的 Plan 模式那样——只能在开头把假设亮出来一次,照顾不到中途才做出的那些假设。至今没有解决的,是那个没有任何现成检查看得见的选择。 「有些参数本身就是意图。」 调色师的一版调色不是机械操作。我们同意参数可以承载意图;我们的主张是关于意图在哪里表达:在结构性的抓手上,通过指出位置并说出原因来表达,而不是靠握住每一个滑杆。专家应当永远可以展开细节。对那些「控件本身就是思考工具」的手艺,我们可能是错的。 「原子级权限放大了破坏面。」 确实可能。但细粒度的命令也让每个任务的授权可以比一个整体式封装更窄,还能把不可逆的那些单独拎出来。即便如此,一个被劫持、又握有全部原子权限的 Agent,依然是界面设计消除不了的严重风险。 「你们的证据很弱。」 确实是观测性的:打开 Mini App 是用户自己的选择,基线只是能找到的最接近的对照;修正从打字变成直接操作,本身也会让打出来的抱怨变少。我们依赖的是每一组对比的方向都一致,而不是其中任何一组。 「轮次多不等于好。」 我们同意,轮次是把双刃剑。轮次更多,可能意味着面板把人带进了探索和更深入的工作,这是我们对图 4(a) 的读法。但人在什么时候停下同样重要:因为结果已经令人满意而早早停下,恰恰说明工具和模型把事情做对了。Finance 这一行同时露出了两面:对比纯网页搜索,带面板的会话更常继续;而在我们日志的另一个口径里——限定在金融投研、对比无界面的数据工具——它继续得反而更少,我们的理解是人更快拿到了想要的东西。所以我们把「继续」和受挫信号放在一起读:多出来的那些轮次,究竟是在打磨,还是在返工。 「折叠了 How,Why 就更没处学了。」 我们没有完整的答案。滚动的日志同样教不会人,但确实有东西教会过人,那就是亲手写 How。为学习者有意展开细节、在关键节点上逼人停下来想一想,都只是方向,还算不上解法。六、想和同行讨论的问题
- 使用深度。 非 Coding 场景里「检索 + 一次性产出」的形态是普遍的吗?如果你们的产品撬动了它,撬动它的是模型、记忆,还是界面?
- 寻找关键节点。 我们呈现的是「所有检查都能通过的选择」。你们如何决定该呈现什么?有没有人让 Agent 在运行时可靠地声明自己的假设?
- 抓手清单。 选点、图层、轨道是我们的。你们领域里最小的那组抓手是什么?我们能不能一起攒出一份共享的清单?
- 度量。 轮次和打字反馈都是很差的代理指标。你们用什么替代?各家产品能否约定一小组方向性的指标,在不披露体量的前提下彼此交换?
- 判断力的生长。 当 How 被折叠之后,你们如何让经验尚浅的人继续学会 Why?
- 底座。 你们的产品有哪些操作是以权限清晰的原子命令形式开放给 Agent 的?结构化查询在哪里赢了相似度检索,又在哪里没有赢?
结语
「精确指令、即时反馈」这份契约,撑不住一个以机器速度规划、行动并改变世界的 Agent。我们的回应有三部分:给人一个意图能够形成的环境;给人一个编辑意图的中间态,把可逆的过程折叠起来,把模型的假设摆在少数选定的节点上;再给 Agent 一个能把意图可靠执行出来的确定性底座。 全文最想留下的是两句话:安全上的可逆,并不能自动转化为认知上的可控;不写 How 之后,人更难学会 Why。 我们持有这个立场,凭的是实践,以及一些指向同一个方向的信号。比起被认同,我们更希望它被同行检验。参考文献
- Ananny, M. & Crawford, K. (2018). Seeing without Knowing. New Media & Society, 20(3).
- Anthropic (2025). Making Claude Code Safer with Sandboxing.
- Bainbridge, L. (1983). Ironies of Automation. Automatica, 19(6).
- Becker, J., Rush, N., Barnes, E. & Rein, D. (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. METR.
- Bedard, J. et al. (2026). When Using AI Leads to “Brain Fry”. Harvard Business Review.
- Brynjolfsson, E., Chandar, B. & Chen, R. (2025). Canaries in the Coal Mine? Stanford Digital Economy Lab.
- Brysbaert, M. (2019). How Many Words Do We Read per Minute? Journal of Memory and Language, 109.
- Buçinca, Z., Malaya, M. B. & Gajos, K. Z. (2021). To Trust or to Think. PACM HCI, 5(CSCW1).
- Chalmers, M. & MacColl, I. (2003). Seamful and Seamless Design in Ubiquitous Computing. UbiComp 2003 Workshop.
- Chatterji, A. et al. (2025). How People Use ChatGPT. NBER Working Paper 34255.
- DORA (2024). Accelerate State of DevOps Report 2024.
- Gibson, J. J. (1979). The Ecological Approach to Visual Perception. Houghton Mifflin.
- Harding, W. & Kloster, M. (2024). Coding on Copilot. GitClear.
- Heer, J. (2019). Agency plus Automation. PNAS, 116(6).
- Kosmyna, N. et al. (2025). Your Brain on ChatGPT.
- Lee, H.-P. et al. (2025). The Impact of Generative AI on Critical Thinking. CHI ’25.
- Masson, D. et al. (2024). DirectGPT. CHI ’24.
- Mozannar, H. et al. (2025). Magentic-UI: Towards Human-in-the-loop Agentic Systems.
- Nielsen, J. (1994). Enhancing the Explanatory Power of Usability Heuristics. CHI ’94.
- Nielsen, J. (2023). AI: First New UI Paradigm in 60 Years. Nielsen Norman Group.
- Poursabzi-Sangdeh, F. et al. (2021). Manipulating and Measuring Model Interpretability. CHI ’21.
- Shen, J. H. & Tamkin, A. (2026). How AI Impacts Skill Formation.
- Shneiderman, B. (2020). Human-Centered Artificial Intelligence: Reliable, Safe & Trustworthy. IJHCI, 36(6).
- Shneiderman, B. & Maes, P. (1997). Direct Manipulation vs. Interface Agents. Interactions, 4(6).
- Simkute, A. et al. (2024). Ironies of Generative AI.
- Subramonyam, H. et al. (2024). Bridging the Gulf of Envisioning. CHI ’24.
- Suchman, L. A. (1987). Plans and Situated Actions. Cambridge University Press.
- Tankelevitch, L. et al. (2024). The Metacognitive Demands and Opportunities of Generative AI. CHI ’24.
- Wattenberger, A. (2023). Why Chatbots Are Not the Future.
- Weiser, M. & Brown, J. S. (1996). Designing Calm Technology. PowerGrid Journal, v1.01.